AI技术研报-这里有最前沿的人工智能技术解读

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
3.7万token/s实现千万级家庭仿真,准确率超越硅谷Jev模型,港大罗晔教授团队发布YN决策模型

3.7万token/s实现千万级家庭仿真,准确率超越硅谷Jev模型,港大罗晔教授团队发布YN决策模型

3.7万token/s实现千万级家庭仿真,准确率超越硅谷Jev模型,港大罗晔教授团队发布YN决策模型

香港大学罗晔教授团队发布S²-MAS框架及YN决策模型,以14张GPU在4小时内完成1200万户家庭仿真,YN-mini单卡吞吐量达3.7万token/s,消费金融基准准确率高于Jev 1.13。

来自主题: AI技术研报
8090 点击    2026-11-07 14:48
机器人自己写代码修自己,成功率从17.5%涨到95%:具身智能有了不动权重的自进化框架

机器人自己写代码修自己,成功率从17.5%涨到95%:具身智能有了不动权重的自进化框架

机器人自己写代码修自己,成功率从17.5%涨到95%:具身智能有了不动权重的自进化框架

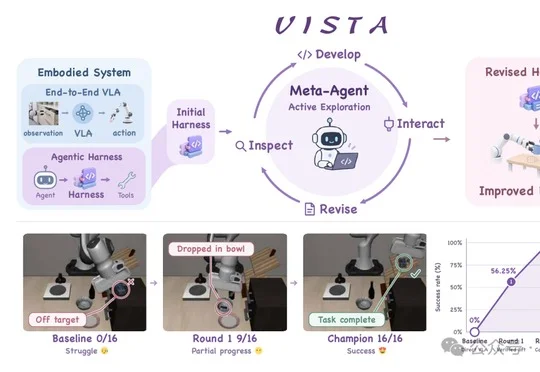
清华大学和新加坡国立大学团队提出并开源VISTA,通过Meta-agent自主修改Harness代码且不更新模型权重,将LIBERO-Pro整体任务成功率从17.5%提升至95.0%。
来自主题: AI技术研报
8647 点击    2026-11-07 14:48
NeurIPS 2026 | 国产昇腾大模型RL训练系统,最高提速222%

NeurIPS 2026 | 国产昇腾大模型RL训练系统,最高提速222%

NeurIPS 2026 | 国产昇腾大模型RL训练系统,最高提速222%

深圳市大数据研究院与华为联合研发的ASP被NeurIPS 2026接收,该系统基于昇腾910B3和MindSpeed-RL,以队列感知调度优化多实例异步RL训练,生成吞吐最高提升222%、单轮迭代时间最多降低76%,并将电信百卡集群训练周期从3个多月缩短至约2个月。
来自主题: AI技术研报
7921 点击    2026-11-07 14:47
NeurIPS 2026 | 从「先出题」到「先探索」:重新思考Tool-Calling Agent的训练数据合成

NeurIPS 2026 | 从「先出题」到「先探索」:重新思考Tool-Calling Agent的训练数据合成

NeurIPS 2026 | 从「先出题」到「先探索」:重新思考Tool-Calling Agent的训练数据合成

Firefly 在 NeurIPS 2026 提出“先探索、后出题”的训练数据合成流程,利用真实 MCP Server 和可离线复现的检索增强模拟器生成5,144个可验证任务,使 Qwen3-4B-Thinking-2507 的 pass@1 从28.1%升至41.5%。
来自主题: AI技术研报
7913 点击    2026-11-07 14:47
「假电脑」教AI用电脑,出的题连GPT-6 Astra都做不对

「假电脑」教AI用电脑,出的题连GPT-6 Astra都做不对

「假电脑」教AI用电脑,出的题连GPT-6 Astra都做不对

微软研究院等团队提出全开源的WildAWM,合成个人电脑环境、跨GUI/MCP/CLI任务及验证器,并训练Qwen3.6-35b-a3b和Qwen3.5-4b,两款模型在8个分布外基准上均获提升,相关环境、任务、模型与数据均已开源。
来自主题: AI技术研报
7211 点击    2026-11-07 14:47
NeurIPS'26 | 如何减少共情推理中的错误传播?

NeurIPS'26 | 如何减少共情推理中的错误传播?

NeurIPS'26 | 如何减少共情推理中的错误传播?

香港中文大学与微软团队提出EchoChat,将感知、心理状态推断与语音回复生成纳入统一优化框架,通过级联门控、SDCA步骤级信用分配和AAA声学注意力约束减少共情推理中的错误传播,相关成果发表于NeurIPS 2026,并发布EchoDialogue-400K数据集与EchoEval评测。
来自主题: AI技术研报
9716 点击    2026-11-07 14:46
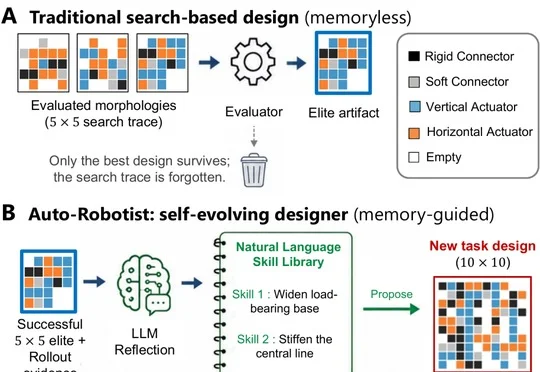
AI 写的东西越来越难懂,Gemini 是怎么做到「说人话」的?

AI 写的东西越来越难懂,Gemini 是怎么做到「说人话」的?

AI 写的东西越来越难懂,Gemini 是怎么做到「说人话」的?

文章分析前沿模型文字难懂的原因,指出 Google 通过 LearnLM 将易读性、命题保真度、认知负荷管理和强化学习后训练融入 Gemini 2.5 Pro 与 Flash,并介绍 UIDPO 和修辞结构对齐两种认知对齐路径。
来自主题: AI技术研报
7263 点击    2026-11-07 14:46
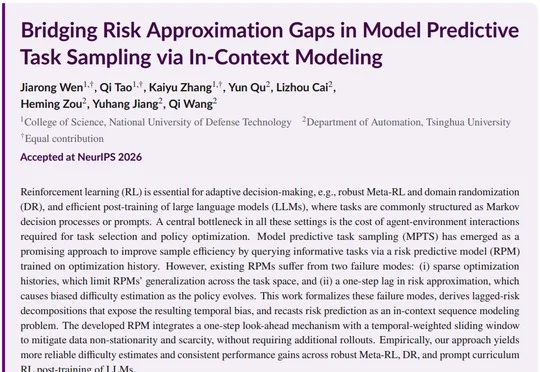
EMNLP'26|AI机器人协同设计智能体:每一次试错都留下经验

EMNLP'26|AI机器人协同设计智能体:每一次试错都留下经验

EMNLP'26|AI机器人协同设计智能体:每一次试错都留下经验

密歇根大学安娜堡分校团队提出并开源AI机器人协同设计智能体Auto-Robotist,相关工作获EMNLP'26主会录用,并在EvoGym七项任务的5×5冷启动实验中以持续更新的技能库复用试错经验,平均最终最优得分高于遗传算法。
来自主题: AI技术研报
7329 点击    2026-11-07 14:46
rollout预算最该花在哪?不是Transformer,而是风险预测的向前一步|NeurIPS'26

rollout预算最该花在哪?不是Transformer,而是风险预测的向前一步|NeurIPS'26

rollout预算最该花在哪?不是Transformer,而是风险预测的向前一步|NeurIPS'26

国防科技大学与清华大学团队提出ICRPM(In-Context Risk Predictive Model),利用近期任务—风险记录预测策略更新后的风险,在无需额外rollout或环境交互的情况下提升大模型RLVR、Meta-RL及鲁棒控制中的任务排序与训练效果。
来自主题: AI技术研报
7806 点击    2026-11-06 15:51
Harness 已经很准了,为什么还需要一个 Agent Native Database

Harness 已经很准了,为什么还需要一个 Agent Native Database

Harness 已经很准了,为什么还需要一个 Agent Native Database

RAGFlow 1.0 以 Go 重写并公开知识编译层与 Retrieval Harness,将产品定位升级为 Agent Native 数据库,通过证据链等编译产物降低 Token 消耗并提升上下文可追溯性。
来自主题: AI技术研报
7255 点击    2026-11-06 15:50
1亿张图,36亿条目标框喂出来的WeVisOne-VL,微信把它开源了

1亿张图,36亿条目标框喂出来的WeVisOne-VL,微信把它开源了

1亿张图,36亿条目标框喂出来的WeVisOne-VL,微信把它开源了

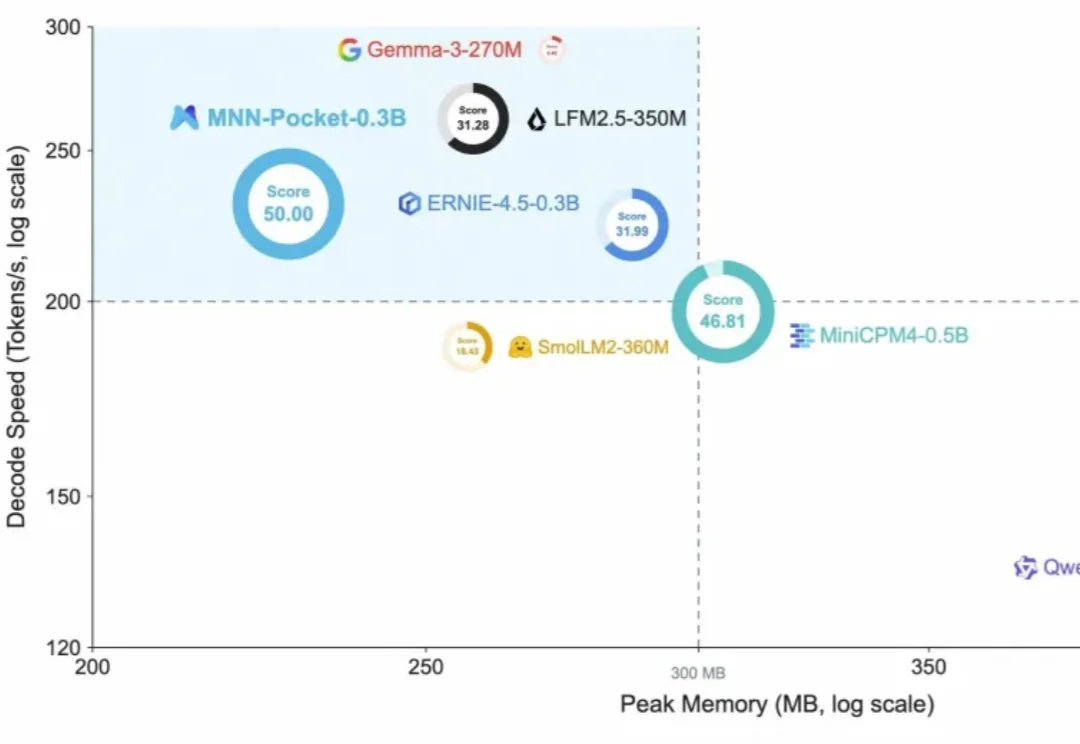
让视觉模型在图里找一样东西,它通常会给出一个框。可如果这样东西根本不在图里呢?
来自主题: AI技术研报
8985 点击    2026-11-06 10:51
Claude进化速度翻倍了,80%增量来自AI

Claude进化速度翻倍了,80%增量来自AI

Claude进化速度翻倍了,80%增量来自AI

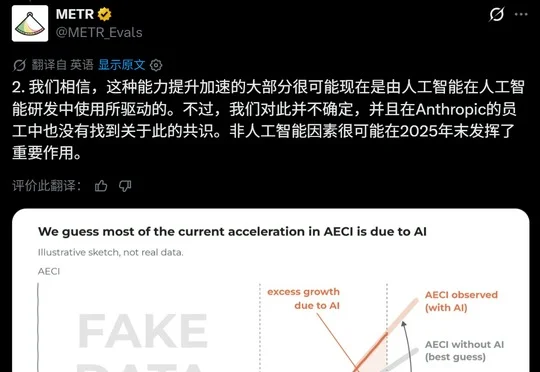
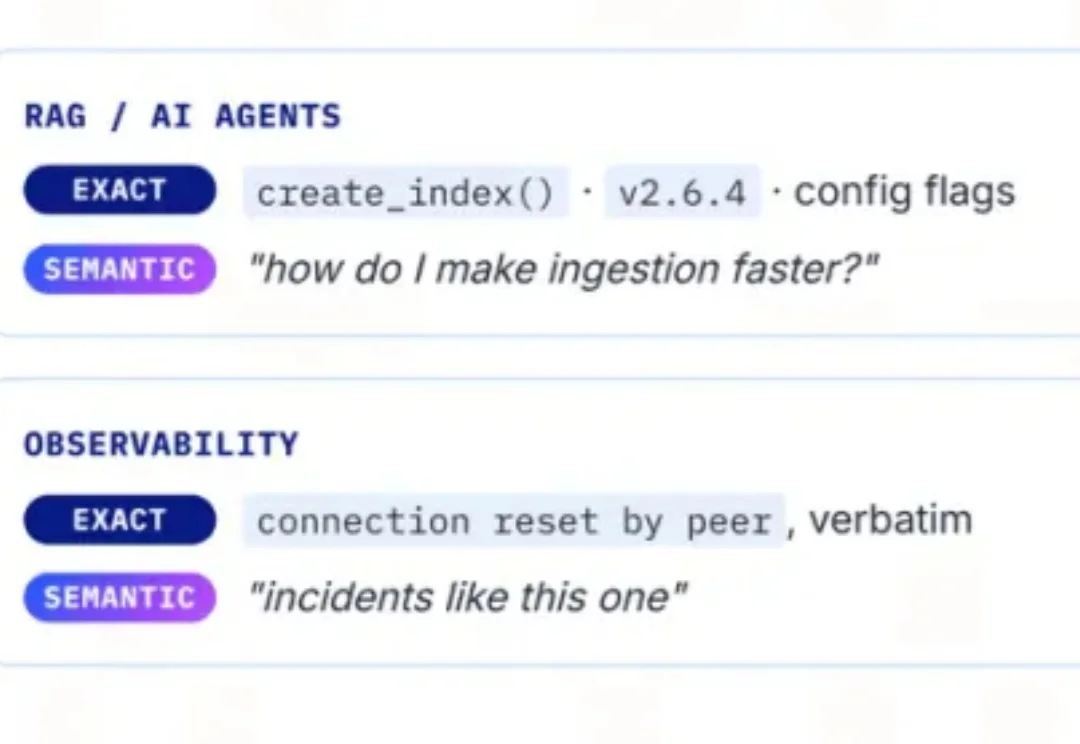
METR 调查报告称,Anthropic 过去一年的基准能力进步约等于此前两年,其中约 80% 的 AI 研究加速来自 AI 辅助人类研发,但距离完整的递归自我改进仍有差距。
来自主题: AI技术研报
7764 点击    2026-11-06 10:35
Milvus 能取代全文检索吗?Milvus 3.0 VS Elasticsearch混合检索实测

Milvus 能取代全文检索吗?Milvus 3.0 VS Elasticsearch混合检索实测

Milvus 能取代全文检索吗?Milvus 3.0 VS Elasticsearch混合检索实测

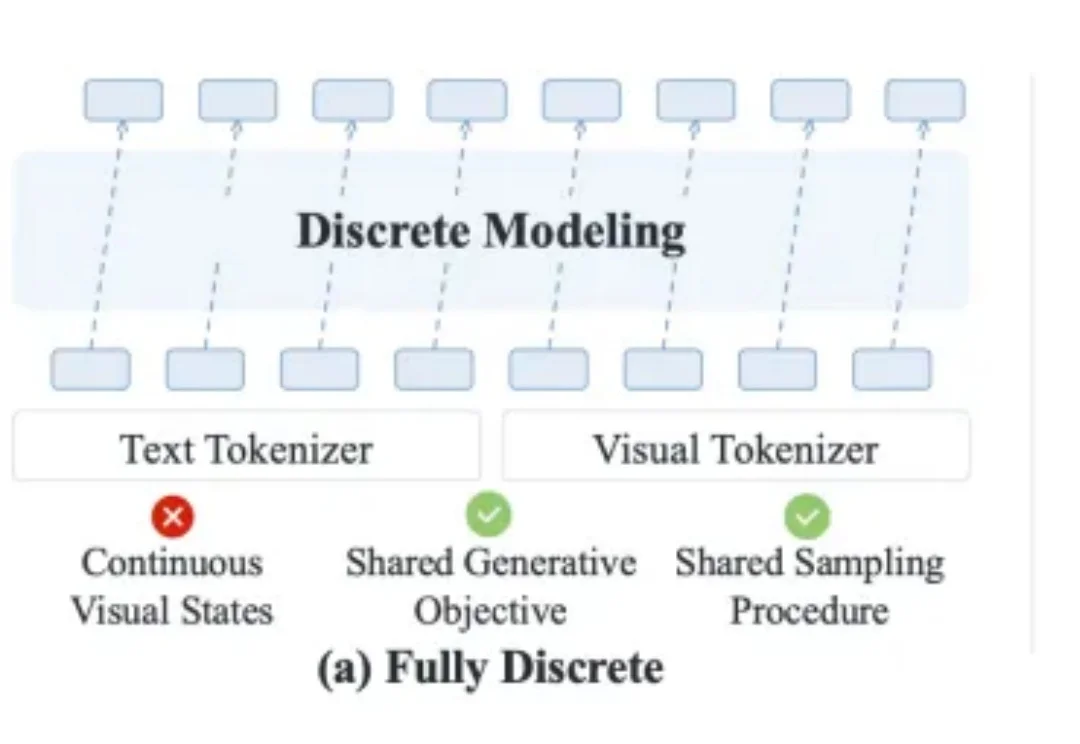
在RAG与Agent、法律以及电商等场景中,语义+关键词的混合检索已经成为越来越多搜索应用的常规配置。
来自主题: AI技术研报
5543 点击    2026-11-06 10:30
不做Token化,也不搞双系统!多模态模型有了第三条路

不做Token化,也不搞双系统!多模态模型有了第三条路

不做Token化,也不搞双系统!多模态模型有了第三条路

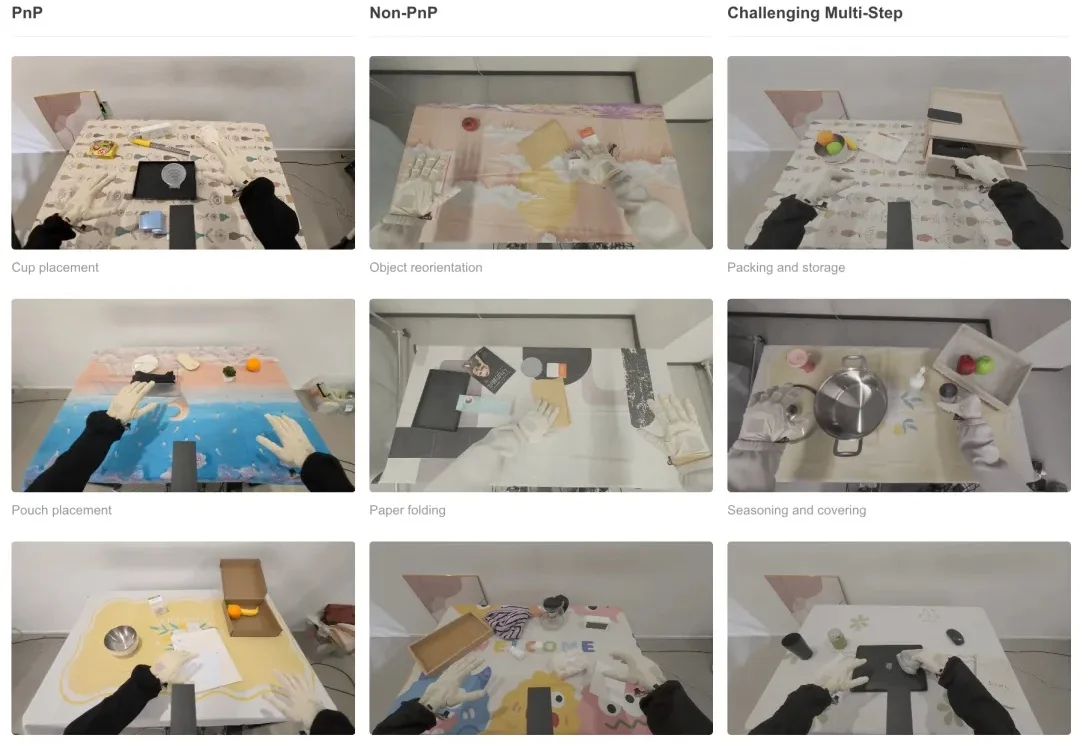
走向物理 AI 时代,构建一个能真正统一语言与视觉的多模态基座模型是关键一步。然而,语言本质上是有序的 Token 序列,视觉则是连续的高维像素分布,两者在信息结构上存在天然的鸿沟。如何在一个模型内统一这两种截然不同的分布,一直是一个备受争论的话题。
来自主题: AI技术研报
9210 点击    2026-11-06 10:29
从RDT-1B到Liber-0,两年间,基模走了多远?

从RDT-1B到Liber-0,两年间,基模走了多远?

从RDT-1B到Liber-0,两年间,基模走了多远?

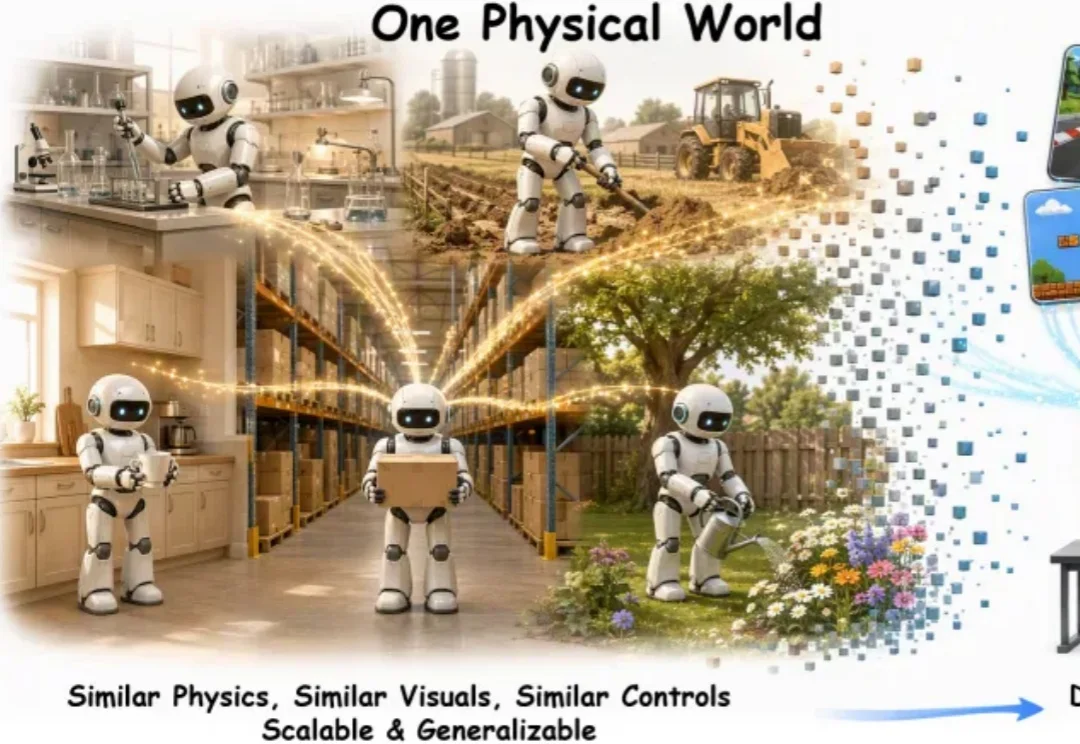
2024 年 10 月,机器之心曾报道过清华团队的一项基模工作:RDT-1B。
来自主题: AI技术研报
5707 点击    2026-11-05 17:32
迈向通用游戏智能,清华、米哈游开源GameScaling系列模型

迈向通用游戏智能,清华、米哈游开源GameScaling系列模型

迈向通用游戏智能,清华、米哈游开源GameScaling系列模型

近日,米哈游联合清华大学、香港大学、新加坡国立大学等学术机构,开源首个通用游戏模型 GameScaling 系列:覆盖 0.8B、2B、9B、27B 四档规模,共八个模型,权重与推理代码均以 Apache 2.0 协议发布。
来自主题: AI技术研报
7587 点击    2026-11-05 17:31
向量数据库+Jev :Graph RAG 可以变得多简单?

向量数据库+Jev :Graph RAG 可以变得多简单?

向量数据库+Jev :Graph RAG 可以变得多简单?

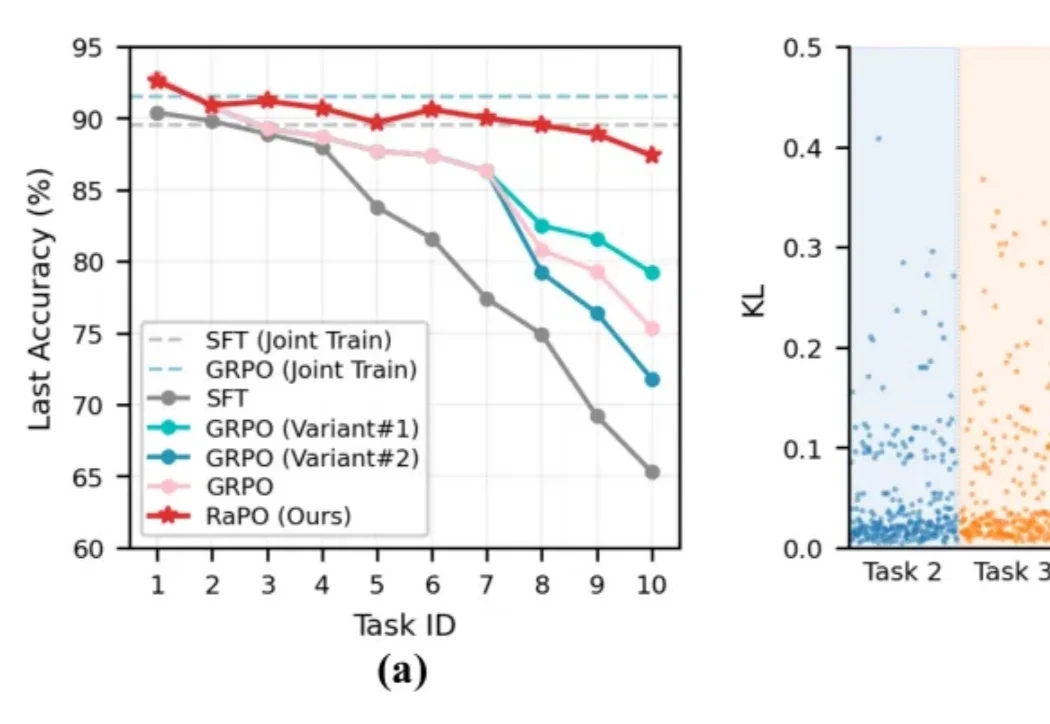
前段时间,我们做了一个开源项目 Vector Graph RAG,尝试只用 Milvus 向量数据库实现知识图谱的多跳检索,省去额外部署图数据库的麻烦。
来自主题: AI技术研报
9865 点击    2026-11-05 17:02
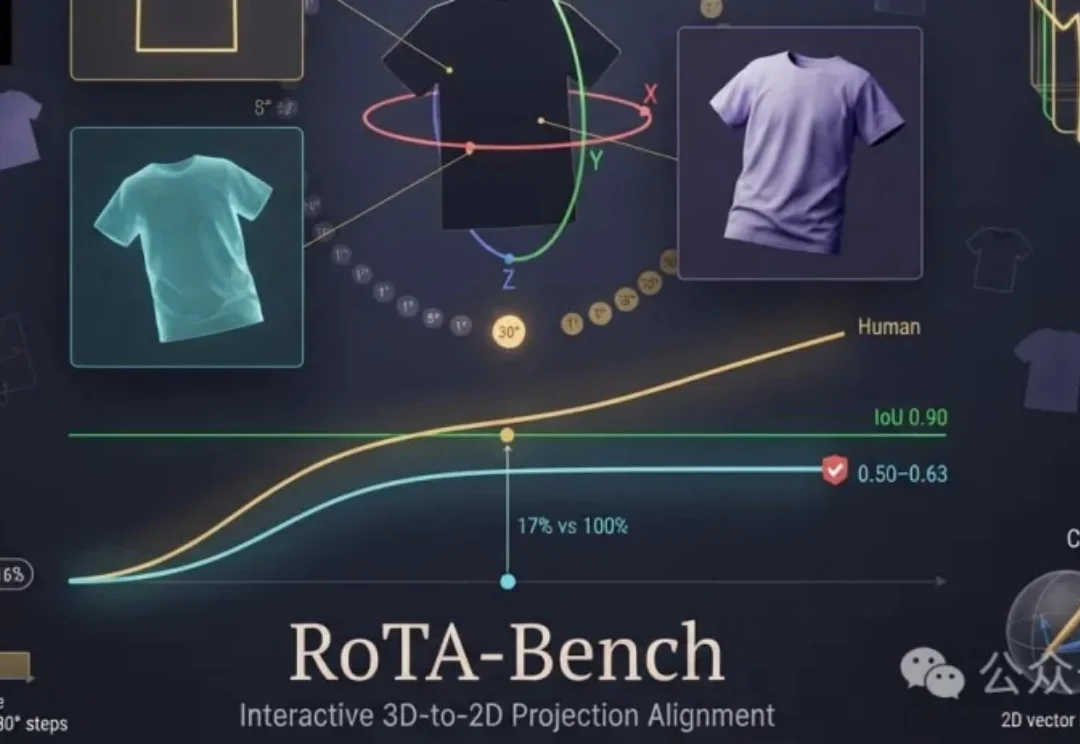
NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源

NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源

NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源

在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。
来自主题: AI技术研报
8310 点击    2026-11-05 17:01
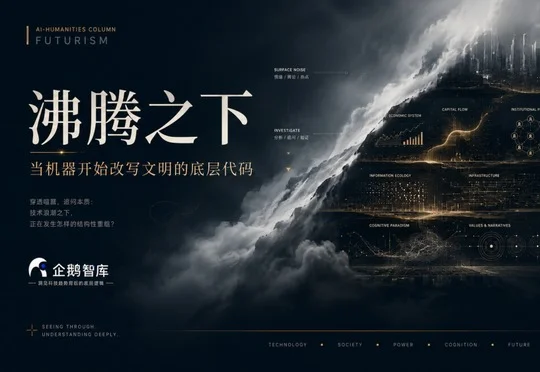
模型能感知调整3D物体位姿吗?首个交互式投影对齐空间推理基准

模型能感知调整3D物体位姿吗?首个交互式投影对齐空间推理基准

模型能感知调整3D物体位姿吗?首个交互式投影对齐空间推理基准

认出一个物体之后,换个角度还能认出来,进一步想象它转动后的样子,这些都涉及空间感知。人类需要在头脑中表示物体的形状与方向,理解不同视角之间的关系,并从二维投影中推断三维几何。
来自主题: AI技术研报
7544 点击    2026-11-05 17:01
我写了Hinton署名的那篇 RSI论文,未来几年 AI 研发可能提速十倍|Sören Mindermann

我写了Hinton署名的那篇 RSI论文,未来几年 AI 研发可能提速十倍|Sören Mindermann

我写了Hinton署名的那篇 RSI论文,未来几年 AI 研发可能提速十倍|Sören Mindermann

Sören Mindermann与Alan Chan牵头、包括Geoffrey Hinton在内的22位学者共同署名的RSI论文提出,在AI研发完全自动化等假设下,研发速度可能在约一年半内提高十倍,但这并非现实时间预测。
来自主题: AI技术研报
7733 点击    2026-11-05 15:46
5000词需求文档,Claude也只能交付14%!实测28种Agent组合

5000词需求文档,Claude也只能交付14%!实测28种Agent组合

5000词需求文档,Claude也只能交付14%!实测28种Agent组合

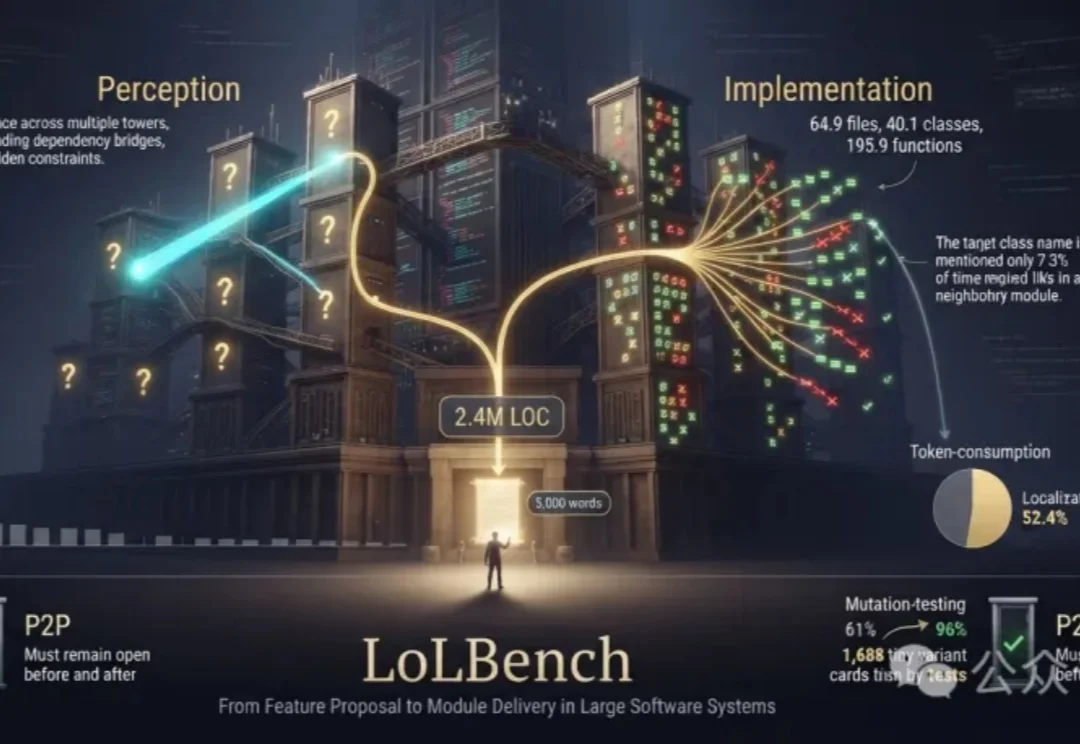
如今Agent已经能熟练调用工具、修改文件、运行测试,但面对一个长期演进的大型软件系统,它能否从一份新需求出发,交付完整功能?
来自主题: AI技术研报
8854 点击    2026-11-05 10:20
决策模型何时需要思考?StartLux-Decision的按需推理与概率校准

决策模型何时需要思考?StartLux-Decision的按需推理与概率校准

决策模型何时需要思考?StartLux-Decision的按需推理与概率校准

经过决策训练的语言模型,重新打开生成开关后,未必还能稳定地推理。在研究者的实验中,4B 模型在约 40% 的问题上几乎不生成推理;9B 模型则走向另一端,在约 70% 的问题上持续生成,直到触及长度上限。
来自主题: AI技术研报
6065 点击    2026-11-05 10:19
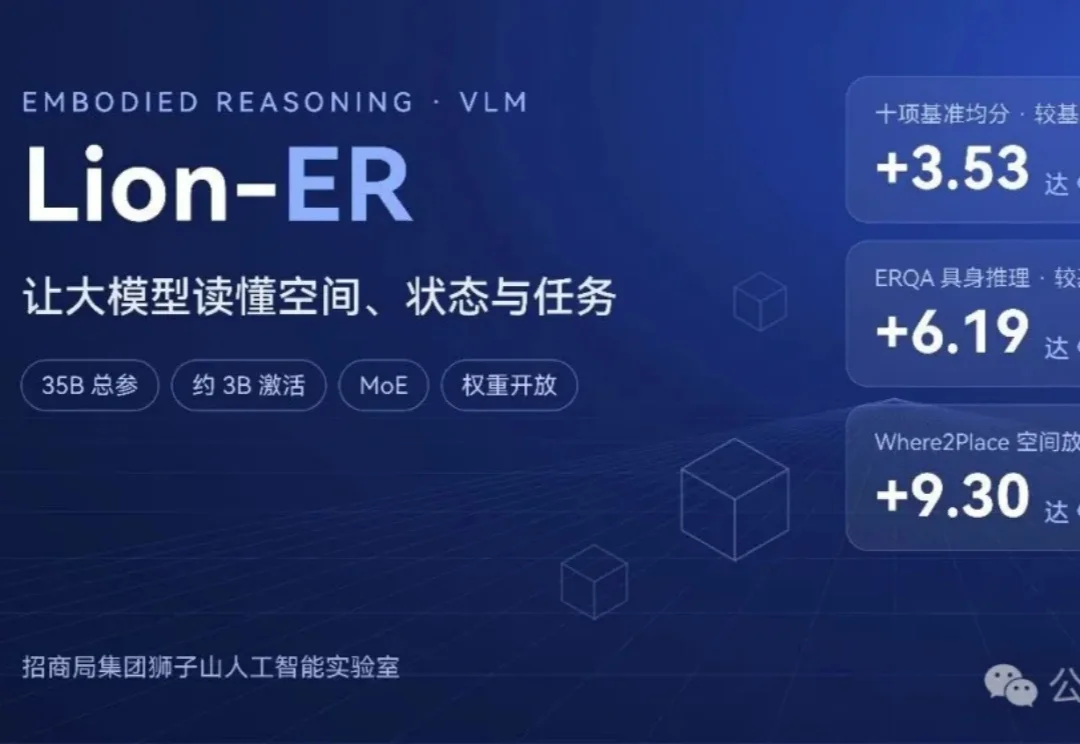
不靠堆砌数据,让机器人看懂真实物理世界 | 招商局狮子山人工智能实验室发布「驭物™ Lion-ER-35B-A3B」具身推理模型

不靠堆砌数据,让机器人看懂真实物理世界 | 招商局狮子山人工智能实验室发布「驭物™ Lion-ER-35B-A3B」具身推理模型

不靠堆砌数据,让机器人看懂真实物理世界 | 招商局狮子山人工智能实验室发布「驭物™ Lion-ER-35B-A3B」具身推理模型

日常生活里人类的直觉判断,放到机器人身上,往往会变成棘手难题。

来自主题: AI技术研报
9466 点击    2026-11-04 15:30
比DeepSeek Super-agent更早,Comma已经把长期记忆做进Agent「大管家」

比DeepSeek Super-agent更早,Comma已经把长期记忆做进Agent「大管家」

比DeepSeek Super-agent更早,Comma已经把长期记忆做进Agent「大管家」

上个月告诉助手「订机票选靠窗座位,优先上午的航班」,这次出差让它订票,它还记得吗?换一个对话、交给另一个执行任务的 Agent,这条要求还在吗?
来自主题: AI技术研报
10424 点击    2026-11-04 15:01