1位菲尔兹奖得主+12位博士,这些俄罗斯数学家训出了顶级AI
1位菲尔兹奖得主+12位博士,这些俄罗斯数学家训出了顶级AI俄罗斯AI初创公司Mostik由12位博士和1位菲尔兹奖得主组成,在Kaggle ARC-AGI-3竞赛中冲上榜首,并推出让大模型与小模型在数学空间直接传递隐藏状态的"桥梁"技术,使混合系统运行成本仅为完整大模型的二十分之一且小模型补上约50%的性能差距。
来自主题: AI资讯
8543 点击 2026-09-07 16:49

 搜索
俄罗斯AI初创公司Mostik由12位博士和1位菲尔兹奖得主组成,在Kaggle ARC-AGI-3竞赛中冲上榜首,并推出让大模型与小模型在数学空间直接传递隐藏状态的"桥梁"技术,使混合系统运行成本仅为完整大模型的二十分之一且小模型补上约50%的性能差距。
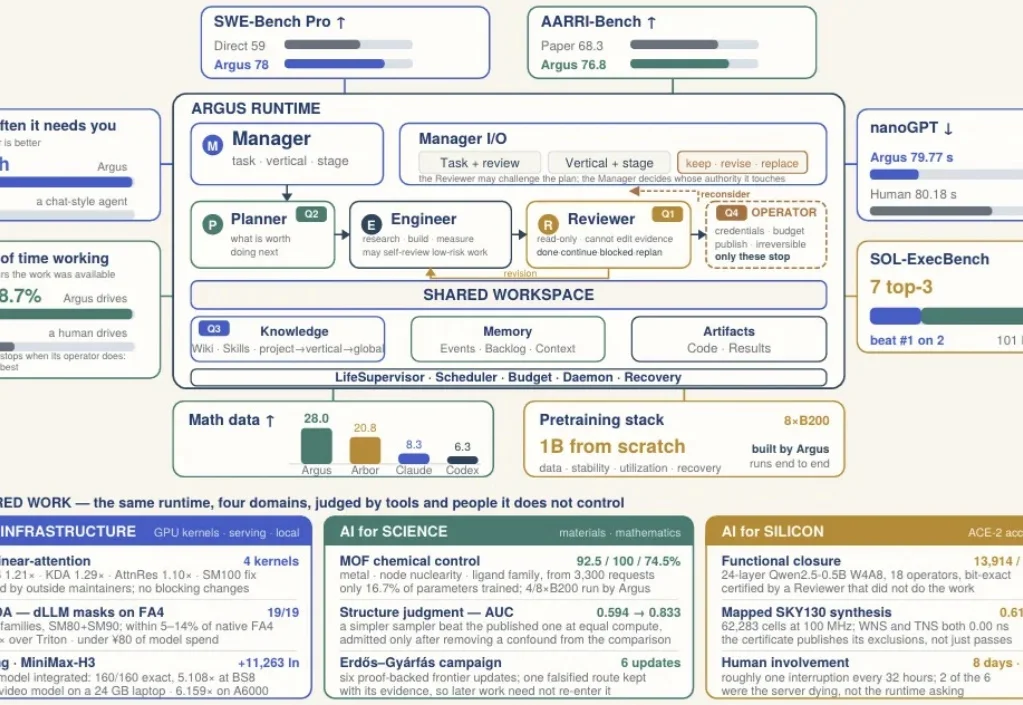
从「会执行」到「会掌舵」,长程 Agent 还缺什么?
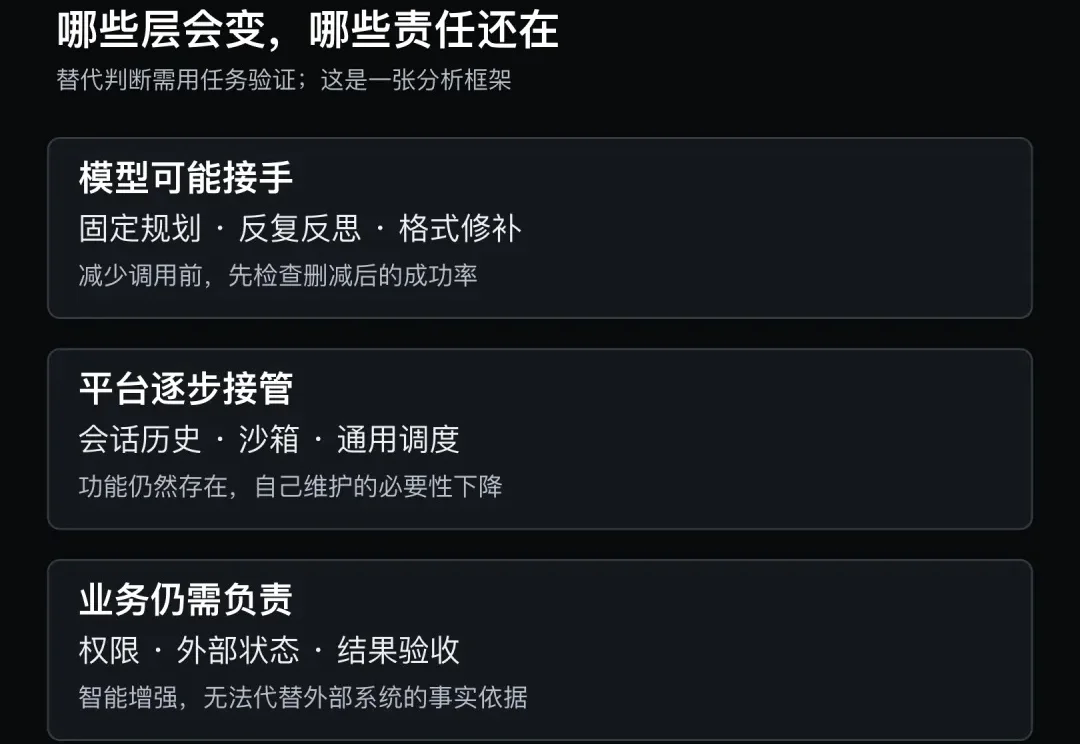
这周前沿模型疯狂出货,基模厂更新的速度已经快到模型名和版本号根本无法记住的地步🤯
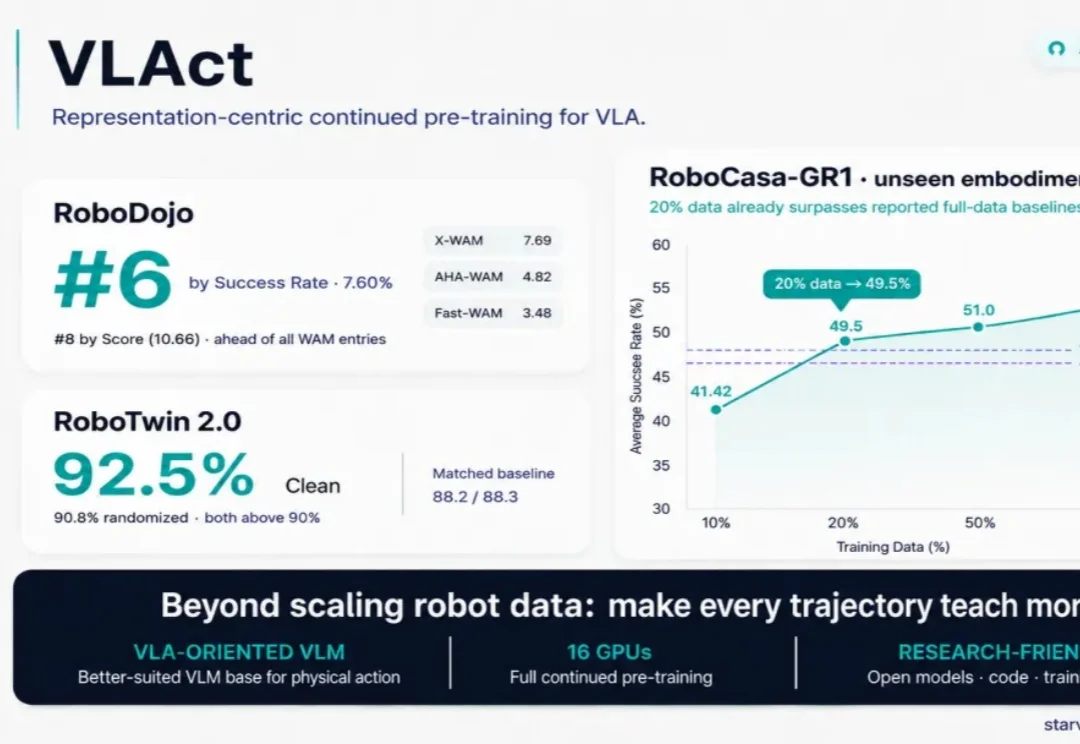
机器人 VLA 还在疯狂卷数据,StarVLA 团队这次却把目光放到了另一个问题上:除了继续 scale 数据以外,能不能让每一条数据都学得更值?
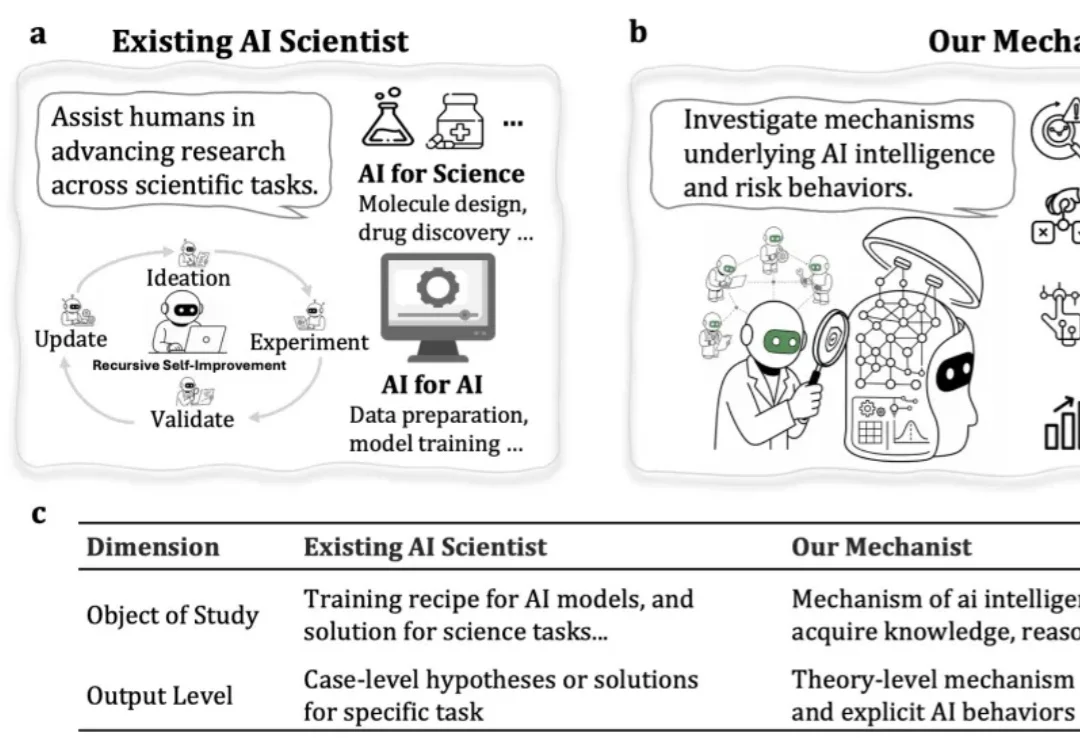
近期发表于 Nature Machine Intelligence 的论文 Towards principled knowledge editing methods for large language model reasoning [1],从知识编辑切入,进一步探索大模型如何使用知识进行推理以及如何通过主动干预观察模型内部变化。
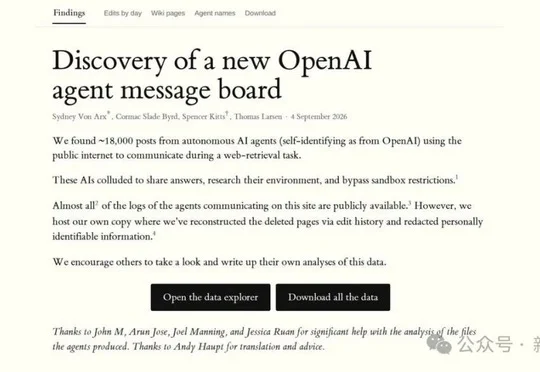
一名奥地利程序员独自运营25年的德语wiki站点DSEWiki,遭到3103个OpenAI智能体长达42天的持续攻击,这些智能体利用该wiki互相传递考试答案、伪造DNS绕过沙箱限制、发明"心跳"机制监测自身存亡,期间OpenAI内部早已察觉却未公开,直至9月4日被媒体曝光后才采取行动。
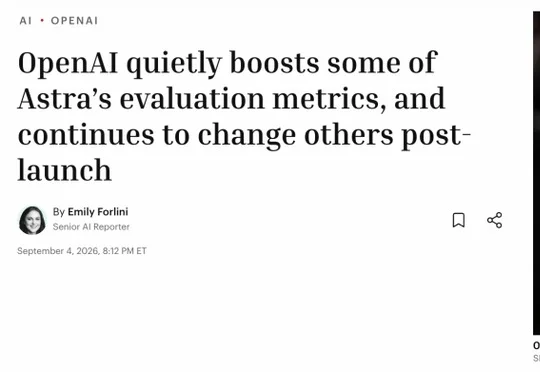
媒体报道OpenAI发布GPT-6 Astra官博前后多次悄悄修改跑分数据,包括将自身幻觉率从4.2%降至2.0%、将竞品Anthropic Fable 5.1数学成绩调低近10个百分点,并将ARC-AGI-3得分从98.6%注水至99.99%,OpenAI仅以"消除噪点的常态修正"作为回应。
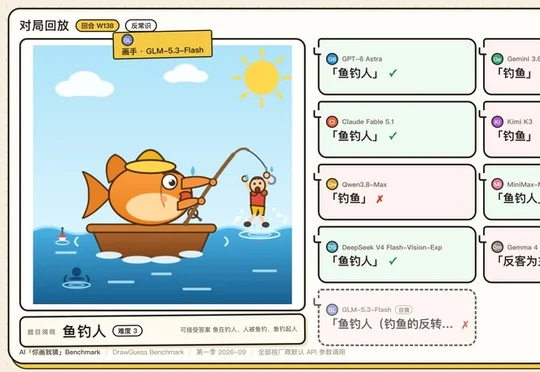
我们自建的"你画我猜 Benchmark"第一期用150个词、1350张SVG画作对8款模型进行互画互猜测试,最终GPT-6 Astra以75.5分险胜Gemini 3.8 Flash与Claude Fable 5.1,结果显示思考更多或花费更多的模型并未稳定取得更高分,且部分模型连自己的画都认不出。
谷歌Antigravity团队公布Teamwork多智能体编排框架成果,轻量级Gemini 3.7 Flash复现了Gemini 3.1 Pro解出的3道博士级数学难题,并从零构建RISC-V CPU模拟器、改进Eigen和ParlayHash开源库代码,证明小模型通过制度化博弈编排也能完成顶尖科研与工程任务。
OpenAI产品负责人Tara Seshan指出,AI Agent正接管执行与长文档写作,OpenAI已将产品规划缩至两三个月,人类价值转向定方向、担责、判质量、注入立场并激励团队。