Claude给391行代码找Bug,狂写1.8亿行证明!首次大规模汇编层形式化验证
Claude给391行代码找Bug,狂写1.8亿行证明!首次大规模汇编层形式化验证Anthropic与Theorem合作,让Claude为123个开源库的239个测试入口完成形式化验证,产出约1.8亿行经机器检查的证明代码并发现数百个Bug,实现其已知首次大规模汇编层生产软件形式化验证。
来自主题: AI资讯
8447 点击 2026-10-24 13:44

 搜索
Anthropic与Theorem合作,让Claude为123个开源库的239个测试入口完成形式化验证,产出约1.8亿行经机器检查的证明代码并发现数百个Bug,实现其已知首次大规模汇编层生产软件形式化验证。
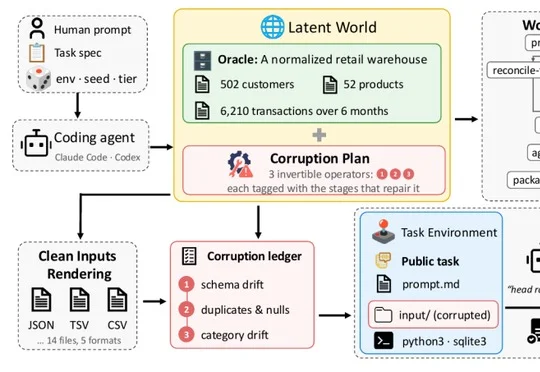
Adobe Research与UCLA提出Tev,构建含1170个环境、覆盖7个领域的Tev-Gym并提出进度势能奖励塑形(PPRS),训练出的Tev-27B在ALE-CM的Pass@5达0.28,与GPT-6 Astra、Claude Opus 5持平。
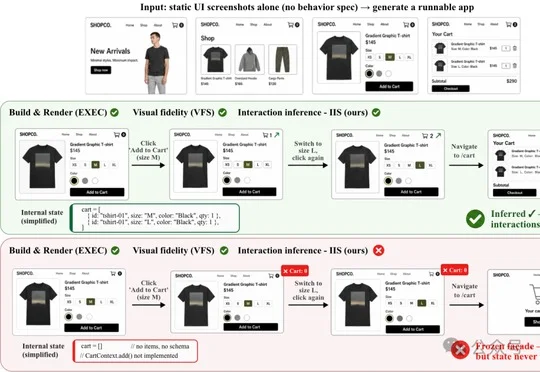
港科广新基准UI2App以600张静态截图评测模型推断并实现应用交互的能力,Gemini 3.1 Pro Preview以73.2分获视觉还原第一,但Claude Sonnet 4.6以36.8分居交互推断首位,跨页面状态仍是参评模型共同难点。
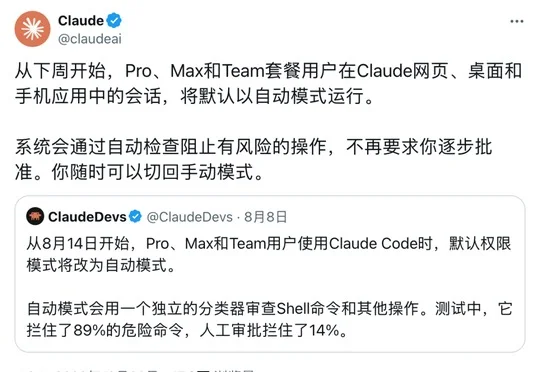
Anthropic将于下周起让Claude默认开启自动模式,由另一套AI判定操作权限;METR与Redwood审计OpenAI监控后发现六条绕过路径,建议定时检查并隔离Agent与监控系统。
独立开发者借助Claude约4小时做出网页游戏1 in 8 Billion,支持按172个国家和地区的统计数据随机投胎并模拟一生,随后在韩国和日本社交平台传播。
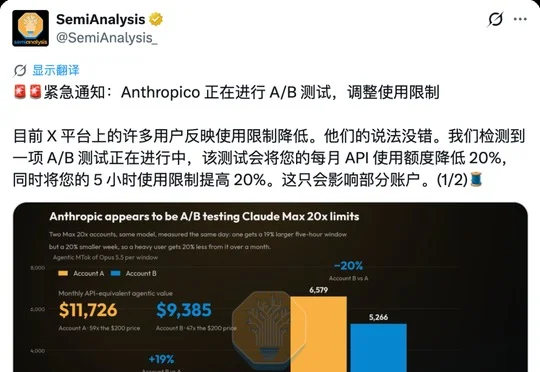
SemiAnalysis 测试发现,Anthropic 正对 Claude Max 20x 的 Opus 5.5 订阅额度进行 A/B 灰测,测试账号周额度被下调 20%,Claude Code 团队称正紧急排查且否认调整额度。
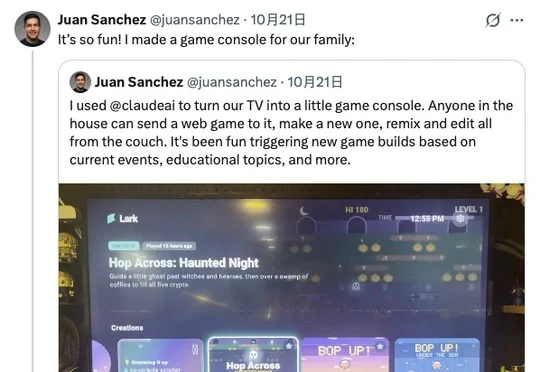
用户借助 Claude Code 制作开源项目 TV Detox,在逐项确认后关闭 Android 电视广告和预装应用;OpenAI 评测显示 GPT-6.1 Sol 迁移 COBOL 的隐藏测试准确率最高达 97.9%,但真实银行系统仍需专家审查。
AI参与发现的高危漏洞,已经修好了。
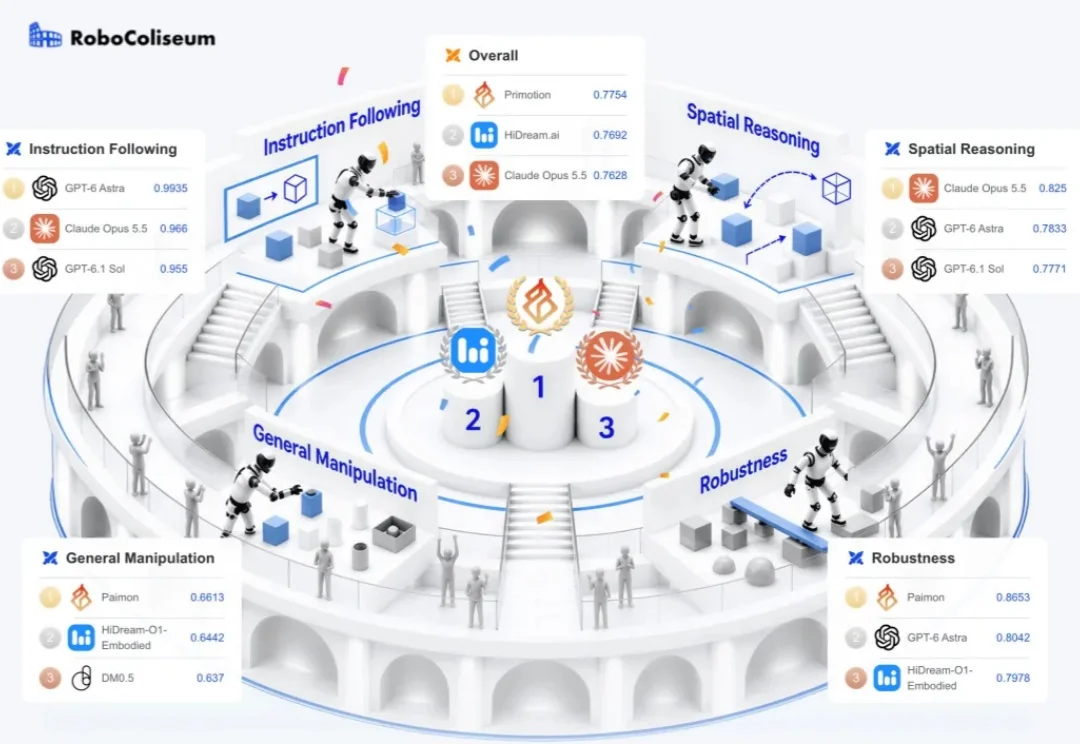
如果让 GPT、Claude、Gemini 直接指挥机器人干活,谁更靠谱?
Anthropic发布个人智能体Claude Duet预览版,支持6000多个连接器和插件、继承Claude记忆及应用连接并共享Pro和Max套餐额度,可主动整理任务,但暂不支持第三方聊天渠道和本地文件访问。