AI资讯新闻榜单内容搜索-Ed

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: Ed
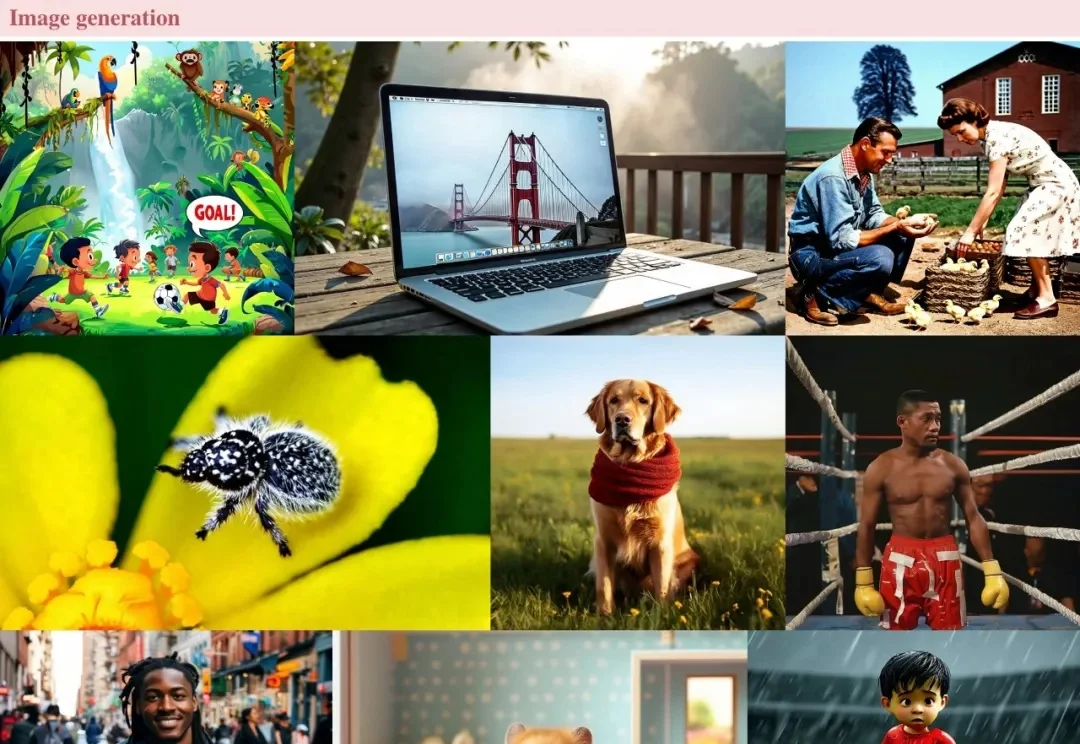
告别VAE和ViT! 英伟达开源PixelUMM, 在像素空间统一视频图像理解与生成

告别VAE和ViT! 英伟达开源PixelUMM, 在像素空间统一视频图像理解与生成

告别VAE和ViT! 英伟达开源PixelUMM, 在像素空间统一视频图像理解与生成

统一多模态模型(Unified Multimodal Models, UMMs)通常为理解和生成分别使用不同的视觉表示:用 ViT 提取理解所需的语义特征,用 VAE 提供生成所需的潜变量。这样一来,同一张图像要以两种 token 进入上下文,视觉上下文随之变长;这种双流接口也不同于视觉-语言模型(VLM)常用的单一视觉流,难以直接沿用成熟的 VLM 预训练流程。

来自主题: AI技术研报
9536 点击    2026-11-02 10:33
NeurIPS 2026 ED Oral丨Benchmark也有保质期?我们给158个评测基准打了分

NeurIPS 2026 ED Oral丨Benchmark也有保质期?我们给158个评测基准打了分

NeurIPS 2026 ED Oral丨Benchmark也有保质期?我们给158个评测基准打了分

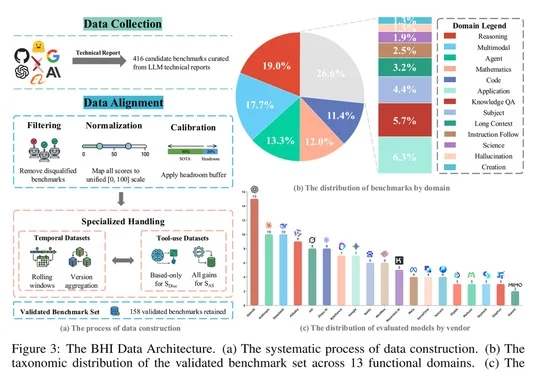
阿里数据团队基于117个模型技术报告筛选158个评测基准,提出基准健康指数(BHI),按能力区分度、抗饱和度和影响力诊断基准,论文获NeurIPS 2026 Evaluations and Datasets Track(Oral)录用,Humanity's Last Exam(HLE)综合第一。

来自主题: AI技术研报
10188 点击    2026-11-01 09:19
10小时数据+一段人手视频=?SkeLAM的零样本跨形态迁移

10小时数据+一段人手视频=?SkeLAM的零样本跨形态迁移

10小时数据+一段人手视频=?SkeLAM的零样本跨形态迁移

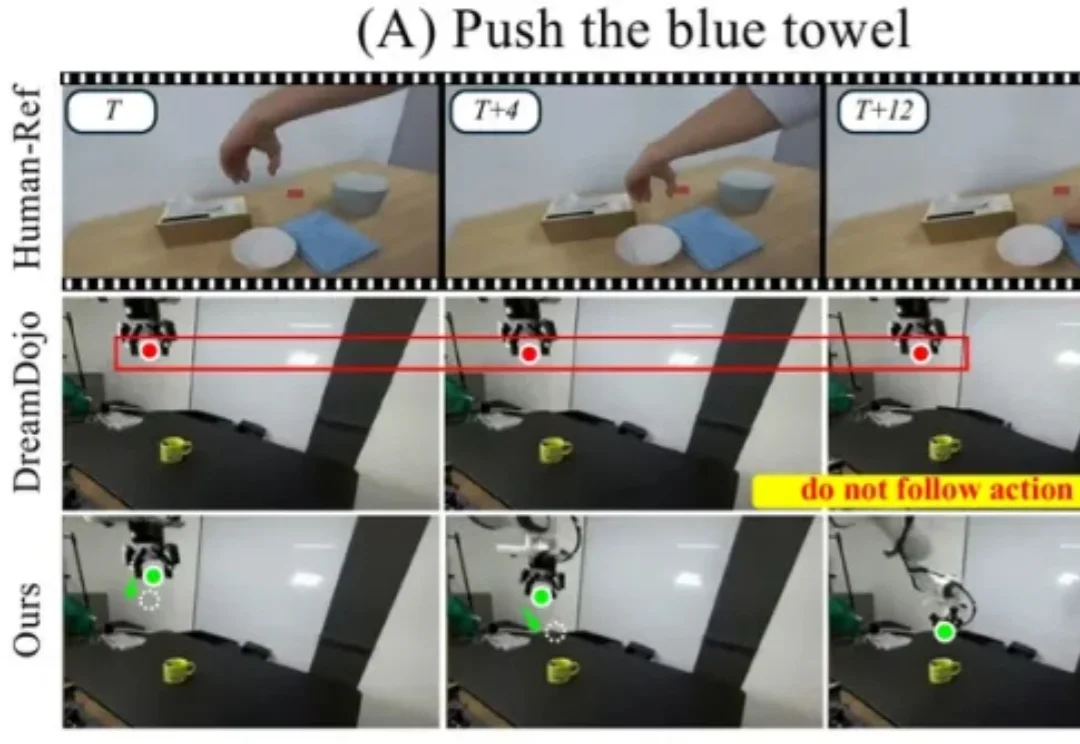
基于预训练的 Cosmos-Predict2.5-2B,SkeLAM 使用总计约 10 小时的机器人交互数据进行训练。在人手到机器人的迁移实验中,输入换成人类演示,生成视频中的机械臂仍然呈现出与演示对应的运动方向。迁移时模型参数全部冻结,没有针对这些演示额外微调。

来自主题: AI技术研报
8245 点击    2026-10-27 13:46
中国的MiniMax,居然成了全日本的希望!?

中国的MiniMax,居然成了全日本的希望!?

中国的MiniMax,居然成了全日本的希望!?

MiniMax与KAGAMIAI等日本伙伴推出H3 IP Edition,利用H3生成内容,并通过Kagami Gate管理日本IP授权、使用记录和收益分配,已有超60家公司表达采用兴趣。

来自主题: AI资讯
11552 点击    2026-10-24 20:10