32B IOI奥赛击败DeepSeek-R1!Open R1开源复刻第三弹,下一步R1-Zero
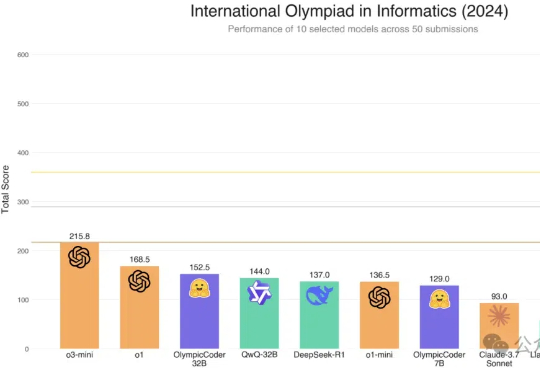
32B IOI奥赛击败DeepSeek-R1!Open R1开源复刻第三弹,下一步R1-ZeroHugging Face的Open R1重磅升级,7B击败Claude 3.7 Sonnet等一众前沿模型。凭借CodeForces-CoTs数据集的10万高质量样本、IOI难题的严苛测试,以及模拟真实竞赛的提交策略优化,这款模型展现了惊艳的性能。
搜索
Hugging Face的Open R1重磅升级,7B击败Claude 3.7 Sonnet等一众前沿模型。凭借CodeForces-CoTs数据集的10万高质量样本、IOI难题的严苛测试,以及模拟真实竞赛的提交策略优化,这款模型展现了惊艳的性能。
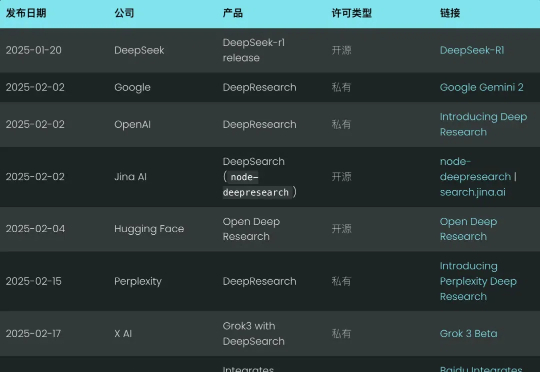
这才 2 月份,深度搜索(Deep Search)就已经隐隐成为 2025 年的新搜索标准了。像谷歌和 OpenAI 这样的巨头,纷纷亮出自己的“Deep Research”产品,努力抢占这波技术浪潮的先机。(我们也很自豪,在同一天也发布了开源的node-deepresearch)。
ChatGPT 平地一声雷,打乱了很多人、很多行业的轨迹和节奏。这两年模型发布的数量更是数不胜数,其中文本大模型就占据了 AIGC 赛道的半壁江山。关注我的家人们永远都是抢占 AI 高地的冲锋者。
哥大的大二学生Roy Lee,靠AI作弊顺利取得亚马逊、Meta、TikTok等大厂的offer!被告发后,哥大在11日将举行听证会,但小哥表示,自己已经买了单程票,到时自己并不会在学校,甚至可能退学。如今,小哥已经成了网红,AI作弊神器Interview Coder卖60美元一个月,公司收入快破百万了。
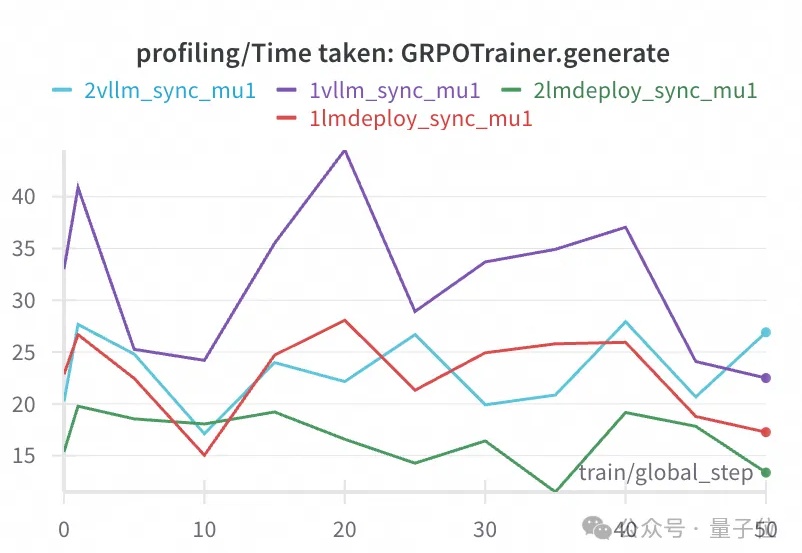
GRPO训练又有新的工具链可以用,这次来自于ModelScope魔搭社区。
回顾 AGI 的爆发,从最初的 pre-training (model/data) scaling,到 post-training (SFT/RLHF) scaling,再到 reasoning (RL) scaling,找到正确的 scaling 维度始终是问题的本质。
DeepSeek R1 催化了 reasoning model 的竞争:在过去的一个月里,头部 AI labs 已经发布了三个 SOTA reasoning models:OpenAI 的 o3-mini 和deep research, xAI 的 Grok 3 和 Anthropic 的 Claude 3.7 Sonnet。
近年来,大型语言模型(LLMs)在代码相关的任务上展现了惊人的表现,各种代码大模型层出不穷。这些成功的案例表明,在大规模代码数据上进行预训练可以显著提升模型的核心编程能力。
原来,大型推理模型(Large Reasoning Model,LRM)像人一样,在「用脑过度」也会崩溃,进而行动能力下降。
大自然的分形之美,蕴藏着宇宙的设计规则。刚刚,何恺明团队祭出「分形生成模型」,首次实现高分辨率逐像素建模,让计算效率飙升4000倍,开辟AI图像生成新范式。