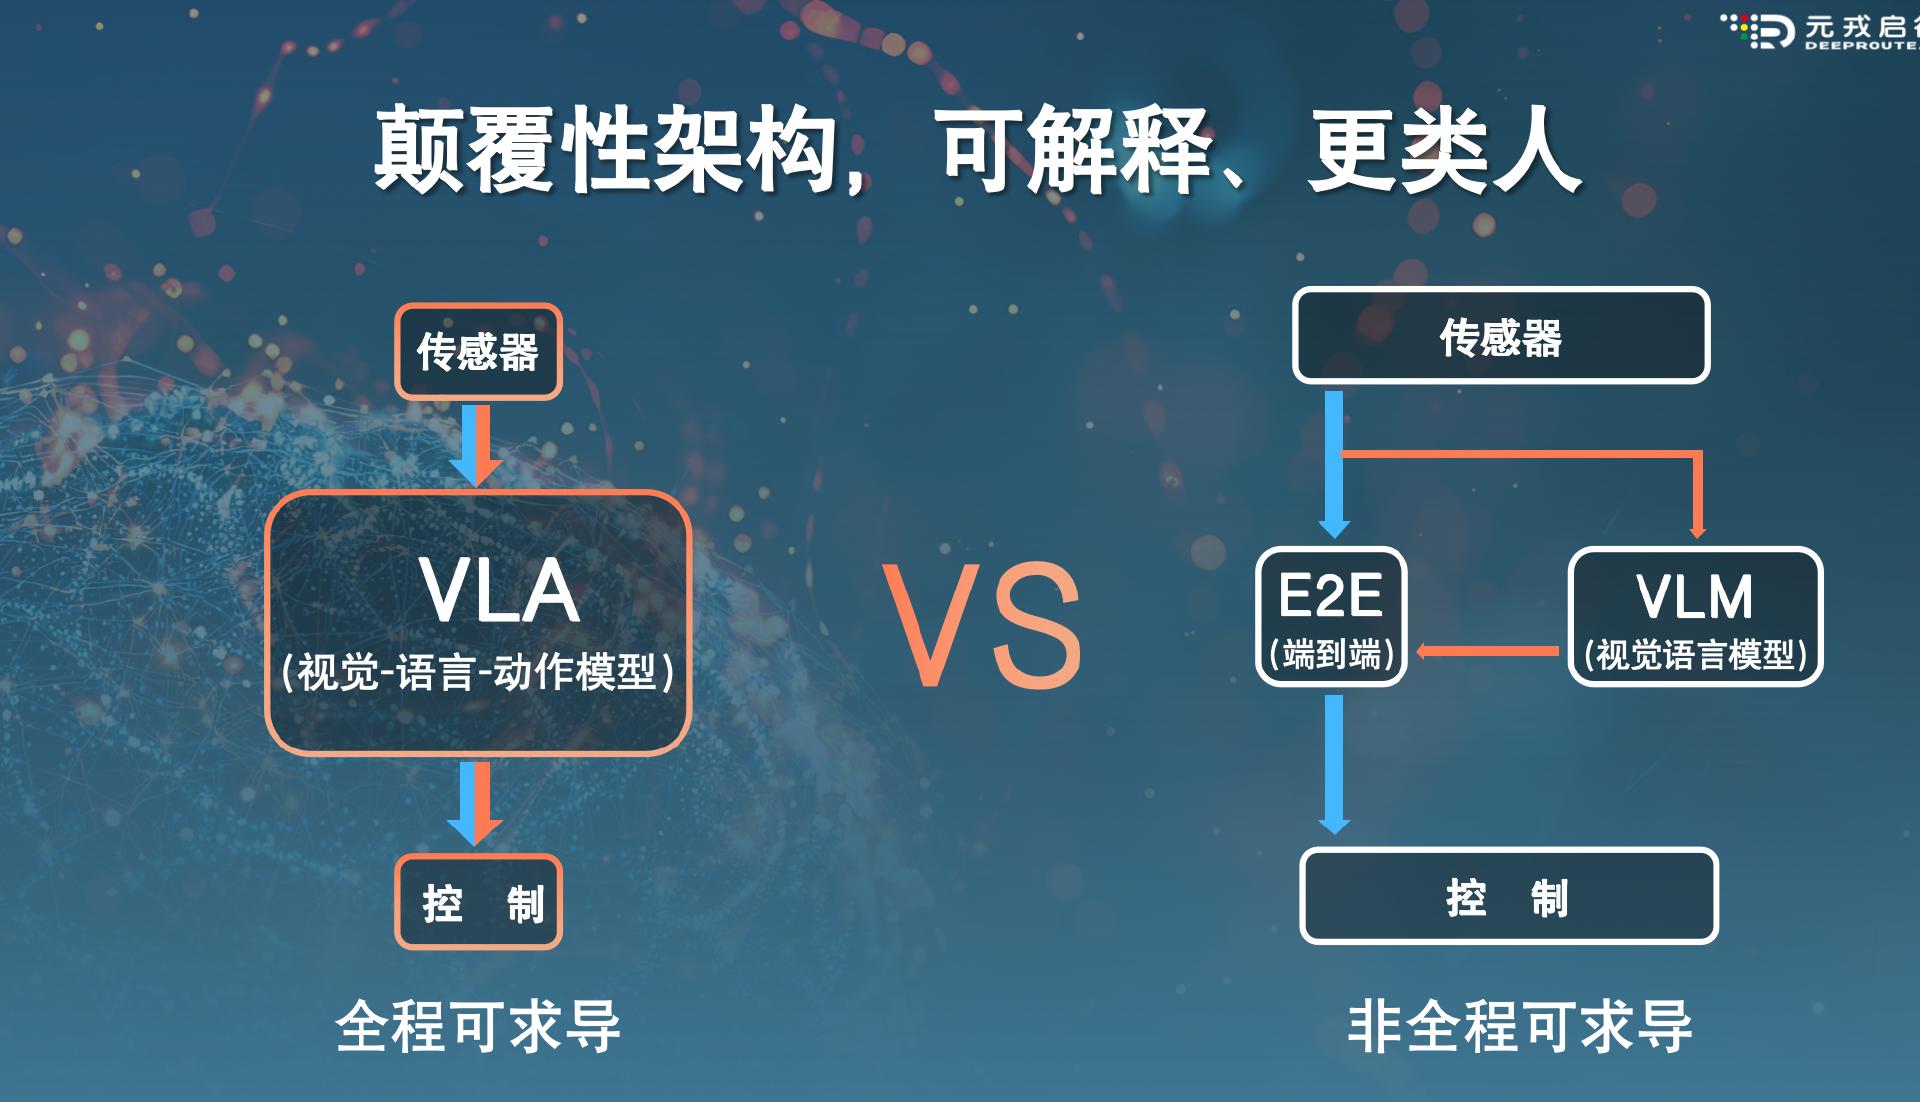
详解“端到端”下一代模型VLA,通向自动驾驶的关键跳板
详解“端到端”下一代模型VLA,通向自动驾驶的关键跳板近期,智驾行业出现了一个融合了视觉、语言和动作的多模态大模型范式——VLA(Vision-Language-Action Model,即视觉-语言-动作模型),拥有更高的场景推理能力与泛化能力。不少智驾人士都将VLA视为当下“端到端”方案的2.0版本。
来自主题: AI资讯
7735 点击 2024-11-09 09:50

 搜索
近期,智驾行业出现了一个融合了视觉、语言和动作的多模态大模型范式——VLA(Vision-Language-Action Model,即视觉-语言-动作模型),拥有更高的场景推理能力与泛化能力。不少智驾人士都将VLA视为当下“端到端”方案的2.0版本。

Tech星球独家获悉,阿里正在测试一款名为“Animode”的AI视频创作工具,官方域名为animode.com.cn,通过工信部网站备案查询可知,该域名的备案主体为杭州连凡信息技术有限公司,该公司也是阿里AI电商工具产品“绘蛙”的开发者。
Segment Anything Model 2(SAM 2)在传统视频目标分割任务大放异彩,引起了众多关注。然而,港中文和上海 AI Lab 的研究团队发现 SAM 2 的贪婪选择策略容易陷入「错误累积」的问题,即一次错误的分割掩码选择将影响后续帧的分割结果,导致整个视频分割性能的下降。这个问题在长视频分割任务中显得更加严重。
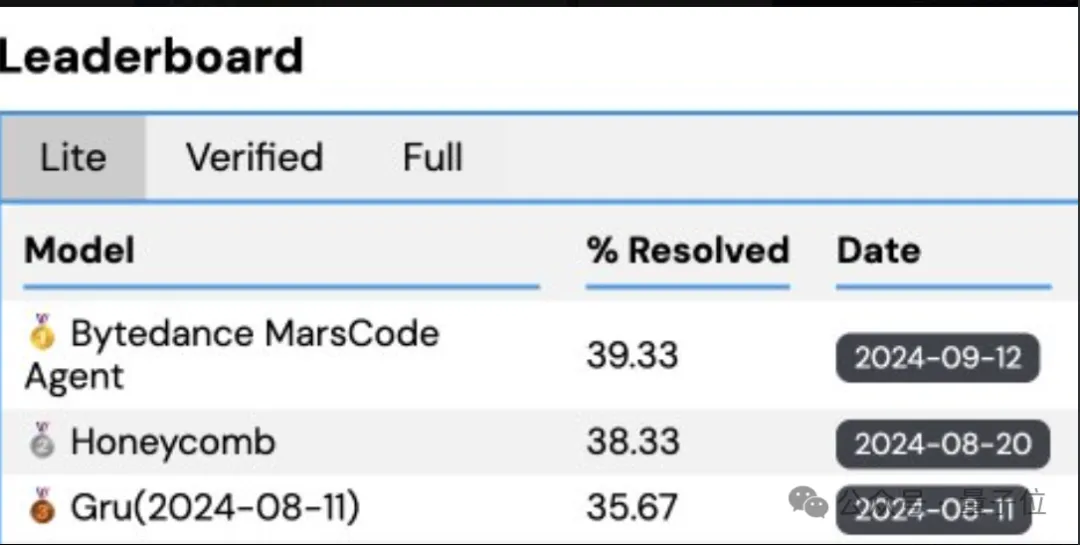
解决真实GitHub Issue的基准测试,字节家的豆包MarsCode Agent悄悄登顶了。SWE-Bench,一个由普林斯顿大学提出的极具挑战性的Benchmark,近期受到工业界、学术界和创业团队的广泛关注。
Agent-to-Sim (ATS) 是一个创新的三维模拟系统,能够从日常视频集合中学习三维代理的交互行为模型,由 Meta Codec Avatar 实验室主导研发。
近年来,大语言模型(Large Language Models, LLMs)的研究取得了重大进展,并对各个领域产生了深远影响。然而,LLMs的卓越性能来源于海量数据的大规模训练,这导致LLMs的训练成本明显高于传统模型。
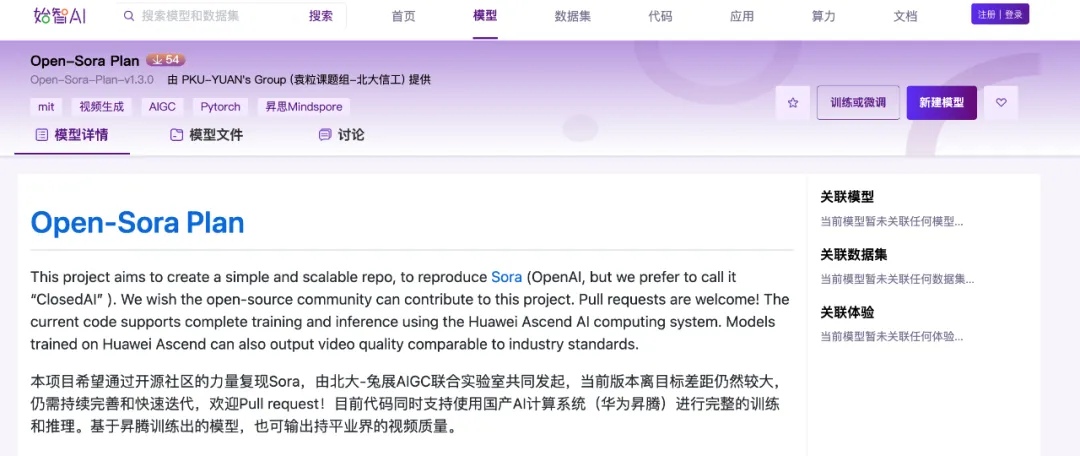
Open-Sora-Plan迎来又一次升级。新的Open-Sora-Plan v1.3.0版本引入了五个新特性:性能更强、成本更低的WFVAE;Prompt refiner;高质量数据清洗策略;全新稀疏注意力的DiT,以及动态分辨率、动态时长的支持。
北京时间 10 月 30 日,GitHub Universe 2024 如约而至,而今年正值大会十周年纪念日。本文将从 GitHub 发布的 AI 新进展入手,围绕开源模型、用户数量、盈利模式、发展历程等几个方面,全面梳理 GitHub 与 Hugging Face 两大开源平台的异同。
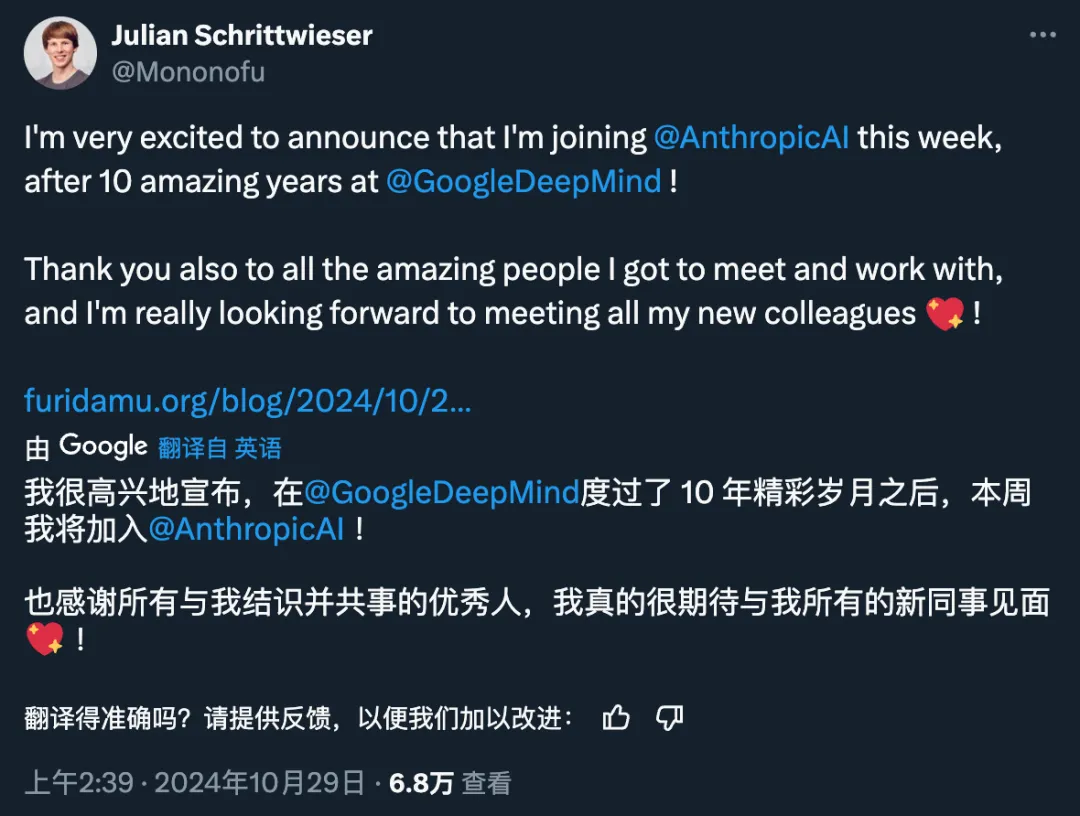
从 AlphaGo、AlphaZero 、MuZero 到 AlphaCode、AlphaTensor,再到最近的 Gemini 和 AlphaProof,Julian Schrittwieser 的工作成果似乎比他的名字更广为人知。
Anthropic CEO Dario Amodei 预测,凭借强大的AI的力量,生物学和医学将加速进步,在未来5-10年内实现原本需要50-100年的成果。他称这一现象为“压缩的21世纪”,即AI能够让人类在几年内取得整整一个世纪的生物医学成就。