AI资讯新闻榜单内容搜索-ODE

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: ODE
银河通用全新模型统一机器人导航任务,7B参数模型支持实时部署

银河通用全新模型统一机器人导航任务,7B参数模型支持实时部署

银河通用全新模型统一机器人导航任务,7B参数模型支持实时部署

北京大学,银河通用,阿德莱德大学,浙江大学等机构合作,探究如何构建具身导航的基座模型(Embodied Navigation Foundation Model)提出了NavFoM,一个跨任务和跨载体的导航大模型。实现具身导航从“专用”到“通用”的技术跃进

来自主题: AI技术研报
9653 点击    2025-11-09 15:34
HF日趋榜一!真端到端模型AutoDeco终结手动调参解码

HF日趋榜一!真端到端模型AutoDeco终结手动调参解码

HF日趋榜一!真端到端模型AutoDeco终结手动调参解码

大语言模型(LLM)的「炼丹师」们,或许都曾面临一个共同的困扰:为不同任务、不同模型手动调整解码超参数(如 temperature 和 top-p)。这个过程不仅耗时耗力,而且一旦模型或任务发生变化,历史经验便瞬间失效,一切又得从头再来。
来自主题: AI技术研报
12053 点击    2025-11-04 16:14
最具争议性研究:大模型中间层输出可 100% 反推原始输入

最具争议性研究:大模型中间层输出可 100% 反推原始输入

最具争议性研究:大模型中间层输出可 100% 反推原始输入

Transformer 语言模型具有单射性,隐藏状态可无损重构输入信息。

来自主题: AI技术研报
11220 点击    2025-11-04 11:32
Eino ADK:一文搞定 AI Agent 核心设计模式,从 0 到 1 搭建智能体系统

Eino ADK:一文搞定 AI Agent 核心设计模式,从 0 到 1 搭建智能体系统

Eino ADK:一文搞定 AI Agent 核心设计模式,从 0 到 1 搭建智能体系统

当大语言模型突破了 “理解与生成” 的瓶颈,Agent 迅速成为 AI 落地的主流形态。从智能客服到自动化办公,几乎所有场景都需要 Agent 来承接 LLM 能力、执行具体任务。
来自主题: AI技术研报
10633 点击    2025-10-31 10:24
刚刚,智源悟界·Emu3.5重塑世界模型格局,原生具备世界建模能力

刚刚,智源悟界·Emu3.5重塑世界模型格局,原生具备世界建模能力

刚刚,智源悟界·Emu3.5重塑世界模型格局,原生具备世界建模能力

今天,北京智源人工智能研究院(BAAI)重磅发布了其多模态系列模型的最新力作 —— 悟界・Emu3.5。这不仅仅是一次常规的模型迭代,Emu3.5 被定义为一个 “多模态世界大模型”(Multimodal World Foudation Model)。
来自主题: AI资讯
11236 点击    2025-10-30 18:07
当阿里入局全球 AI Coding,战场里的 60 天 | 对话叔同:Qoder 创始人

当阿里入局全球 AI Coding,战场里的 60 天 | 对话叔同:Qoder 创始人

当阿里入局全球 AI Coding,战场里的 60 天 | 对话叔同:Qoder 创始人

“很正确,无比正确” 当我们问起阿里巴巴 Qoder[1] (Agentic Coding 产品)创始人叔同,关于他带领团队冲入全球 AI Coding 这片“红海” 60 天后的感受时,他给出了这样简单而坚定的回答。他的底气,源自一份优秀的成绩单:上线 5 天用户迅速突破 10 万,仅 60 天斩获 50 万开发者用户。
来自主题: AI资讯
10686 点击    2025-10-30 12:40
代码自己改自己?我用1000万DeepSeek跑通了赫胥黎-歌德尔机HGM(附避坑指南)

代码自己改自己?我用1000万DeepSeek跑通了赫胥黎-歌德尔机HGM(附避坑指南)

代码自己改自己?我用1000万DeepSeek跑通了赫胥黎-歌德尔机HGM(附避坑指南)

读者,您好!今天想跟您聊一个硬核又极具启发性的项目——HGM(Huxley-Gödel Machine)。我刚刚一起花了几个小时,从环境配置的坑,一路“打怪升级”到让它最终跑完,相信您可能已经从别的公众号上看到了这篇文章。
来自主题: AI技术研报
10148 点击    2025-10-30 11:24
高效训练新标杆!华人团队开源原生VLM-NEO,以少数据追平顶级模型

高效训练新标杆!华人团队开源原生VLM-NEO,以少数据追平顶级模型

高效训练新标杆!华人团队开源原生VLM-NEO,以少数据追平顶级模型

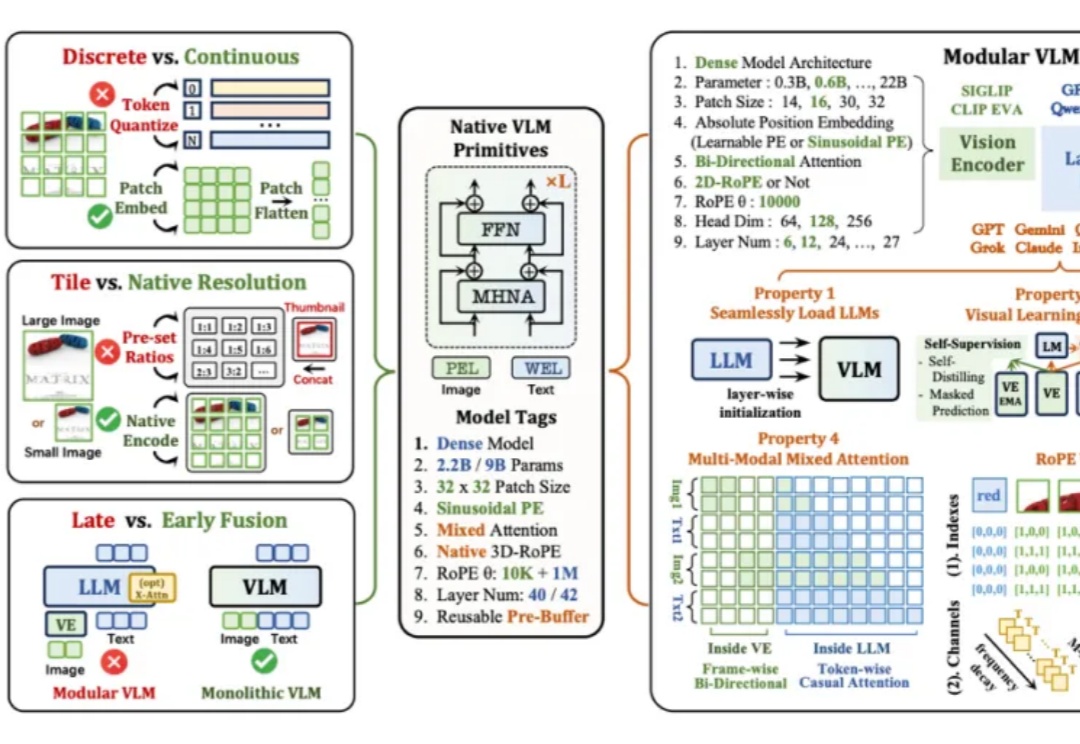
当下主流的视觉语言模型(Vision-Language Models, VLM),通常都采用这样一种设计思路:将预训练的视觉编码器与大语言模型通过投影层拼接起来。这种模块化架构成就了当前 VLM 的辉煌,但也带来了一系列新的问题——多阶段训练复杂、组件间语义对齐成本高,不同模块的扩展规律难以协调。
来自主题: AI技术研报
9469 点击    2025-10-30 10:55
只要强化学习1/10成本!翁荔的Thinking Machines盯上了Qwen的黑科技

只要强化学习1/10成本!翁荔的Thinking Machines盯上了Qwen的黑科技

只要强化学习1/10成本!翁荔的Thinking Machines盯上了Qwen的黑科技

今天要讲的On-Policy Distillation(同策略/在线策略蒸馏)。这是一个Thinking Machines整的新活,这个新策略既有强化学习等在线策略方法的相关性和可靠性;又具备离线策略(Off-policy)方法的数据效率。

来自主题: AI资讯
10799 点击    2025-10-29 11:12
用「进化+压力测试」自动生成的竞赛级编程题,各家大模型谁更hold住?

用「进化+压力测试」自动生成的竞赛级编程题,各家大模型谁更hold住?

用「进化+压力测试」自动生成的竞赛级编程题,各家大模型谁更hold住?

在当前评测生成式模型代码能力的浪潮中,传统依赖人工编写的算法基准测试集,正日益暴露出可扩展性不足与数据污染严重两大瓶颈。

来自主题: AI技术研报
8626 点击    2025-10-29 10:03