印度国家级大模型上线两天仅 300 余次下载,投资人直呼“尴尬”:韩国大学生模型都有20万!
印度国家级大模型上线两天仅 300 余次下载,投资人直呼“尴尬”:韩国大学生模型都有20万!作为首批入选印度“IndiaAI Mission”国家级项目、承担构建印度主权基础大模型任务的公司之一,Sarvam AI 近日发布了名为 Sarvam-M 的模型。这是一个基于 Mistral Small 构建的 240 亿参数、权重开放的混合语言模型。
搜索
作为首批入选印度“IndiaAI Mission”国家级项目、承担构建印度主权基础大模型任务的公司之一,Sarvam AI 近日发布了名为 Sarvam-M 的模型。这是一个基于 Mistral Small 构建的 240 亿参数、权重开放的混合语言模型。
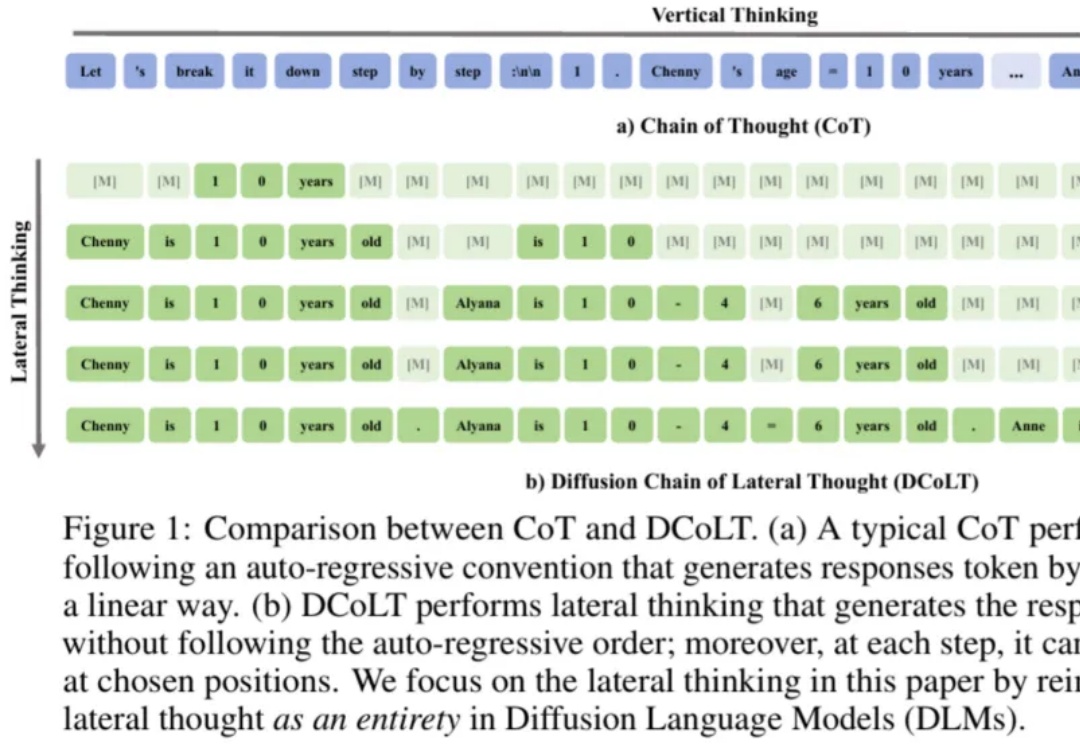
近年来,思维链在大模型训练和推理中愈发重要。近日,西湖大学 MAPLE 实验室齐国君教授团队首次提出扩散式「发散思维链」—— 一种面向扩散语言模型的新型大模型推理范式。该方法将反向扩散过程中的每一步中间结果都看作大模型的一个「思考」步骤,然后利用基于结果的强化学习去优化整个生成轨迹,最大化模型最终答案的正确率。
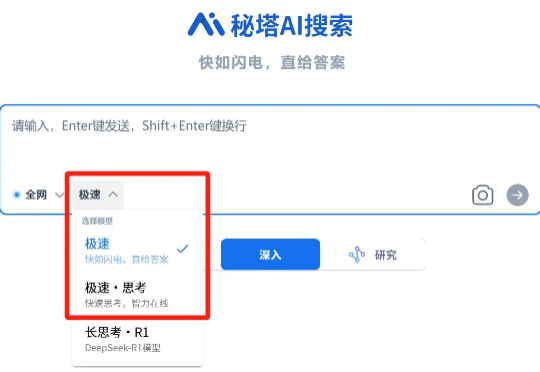
是的,秘塔AI搜索推出了全新“极速”模型。通过在GPU上进行kernel fusion,以及在CPU上进行动态编译优化,我们在单张H800 GPU上实现了最高400 tokens/秒的响应速度,大部分问题2秒内就能答完。
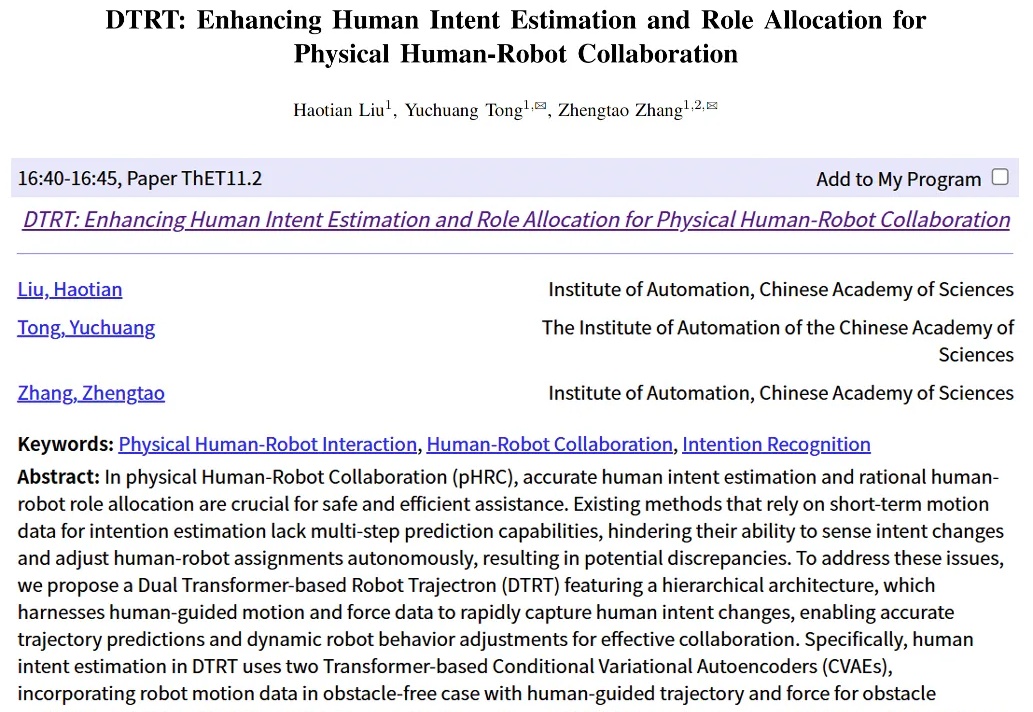
近日,机器人与自动化领域全球顶会 ICRA 2025 在美国亚特兰大开幕。
自 Anthropic 推出 Claude Computer Use,打响电脑智能体(Computer Use Agent)的第一枪后,OpenAI 也相继推出 Operator,用强化学习(RL)算法把电脑智能体的能力推向新高,引发全球范围广泛关注。
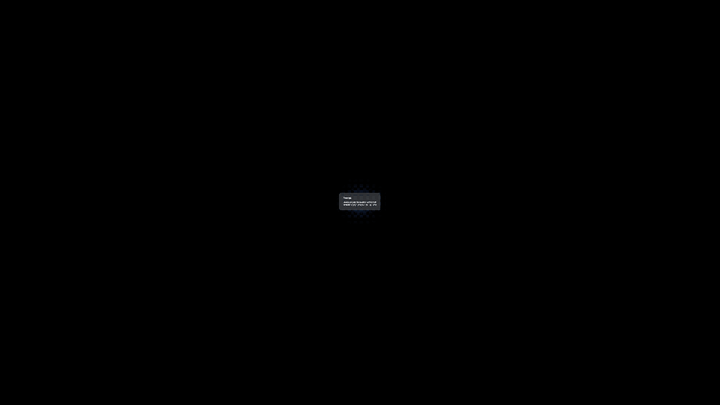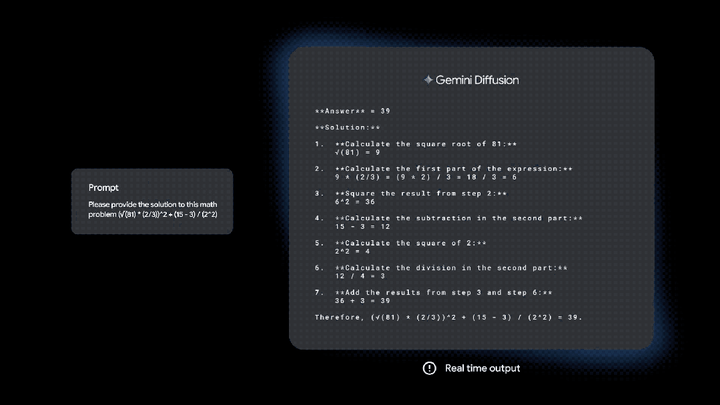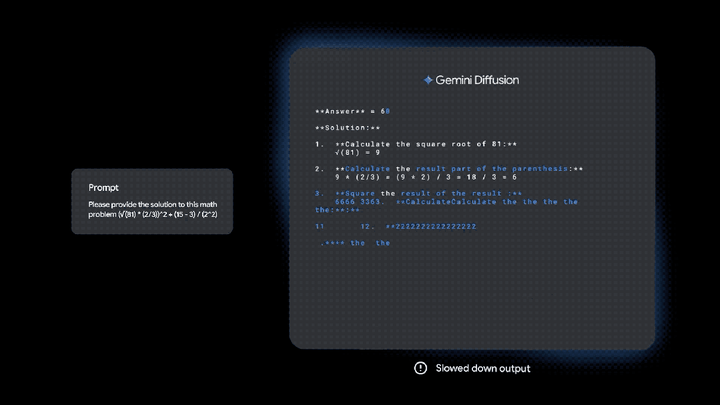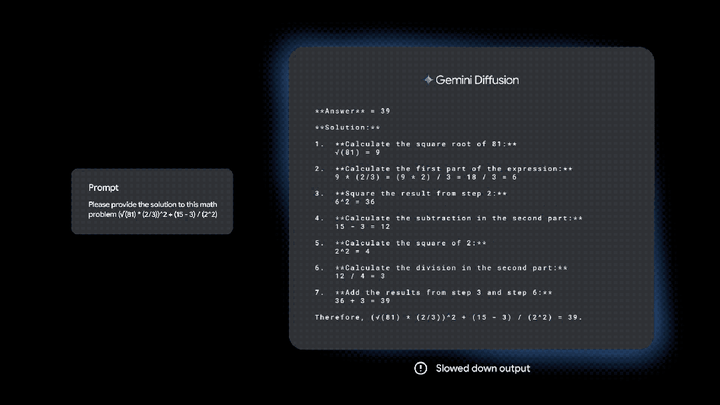
年仅19岁少年,自称破解了谷歌最快的语言模型Gemini Diffusion,引爆社交平台。真相扑朔迷离,但有一点毫无疑问:谷歌I/O大会的「黑马」,比GPT快10倍的速度、媲美人类程序员的代码能力,正在掀起一场NLP范式大洗牌。
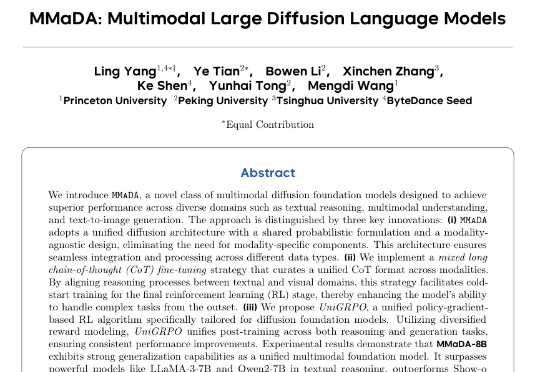
普林斯顿大学与字节 Seed、北大、清华等研究团队合作提出了 MMaDA(Multimodal Large Diffusion Language Models),作为首个系统性探索扩散架构的多模态基础模型,MMaDA 通过三项核心技术突破,成功实现了文本推理、多模态理解与图像生成的统一建模。
谷歌又放新大招了,将图像生成常用的“扩散技术”引入语言模型,12秒能生成1万tokens。
刚刚,昇腾两大技术创新,突破速度瓶颈重塑AI推理。FusionSpec创新的框架设计配合昇腾强大的计算能力,将投机推理框架耗时降至毫秒级,打破延迟魔咒。OptiQuant支持灵活量化,让推理性价比更高。
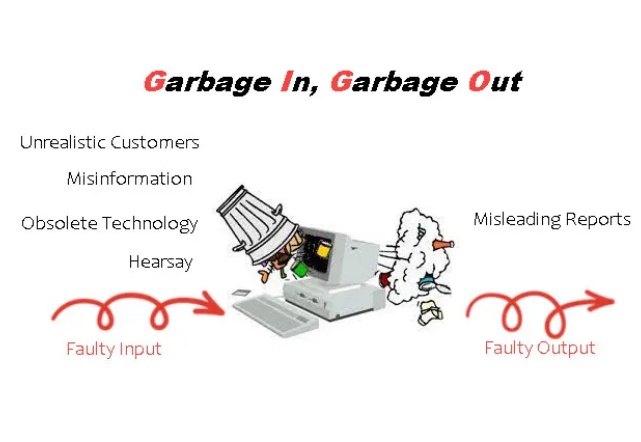
看到朋友在网上的分享: 用Deep Research 的时候就怕在研究来源中看到ZHIHU、SINA、CSDN 这样的网址,这简直就是报告结果的灾难! 垃圾进 垃圾出。。 在大模型还没有进化出反思修正和推理新知识能力的时候,务必屏蔽掉低质量信息源,AI无脑文越演越烈。