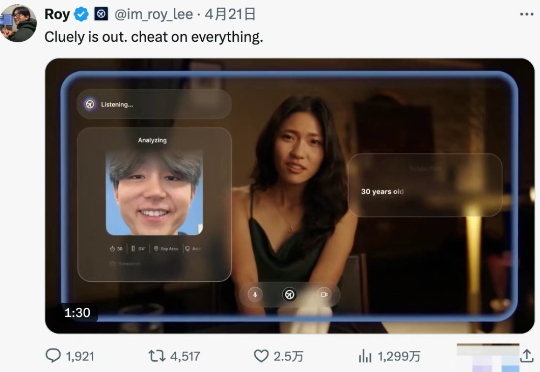
深度分析:为什么a16z敢1500万美金押注一个"作弊工具"?Attention is All You Need的AI时代!
深度分析:为什么a16z敢1500万美金押注一个"作弊工具"?Attention is All You Need的AI时代!你有没有想过,一个因为开发作弊工具被哥伦比亚大学开除的 21 岁学生,竟然能在短短几个月内获得 a16z 领投的 1500 万美元融资?
来自主题: AI资讯
10589 点击 2025-06-29 11:31

 搜索
你有没有想过,一个因为开发作弊工具被哥伦比亚大学开除的 21 岁学生,竟然能在短短几个月内获得 a16z 领投的 1500 万美元融资?
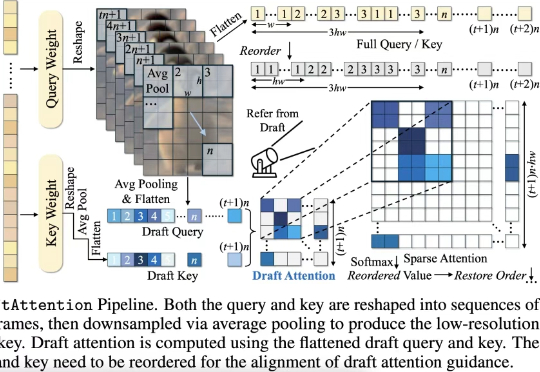
在高质量视频生成任务中,扩散模型(Diffusion Models)已经成为主流。然而,随着视频长度和分辨率的提升,Diffusion Transformer(DiT)模型中的注意力机制计算量急剧增加,成为推理效率的最大瓶颈。
每年数百万患者在医疗转诊中“消失”,这家纽约创业公司用AI重建连接,估值半年飙升至6.05亿美元。
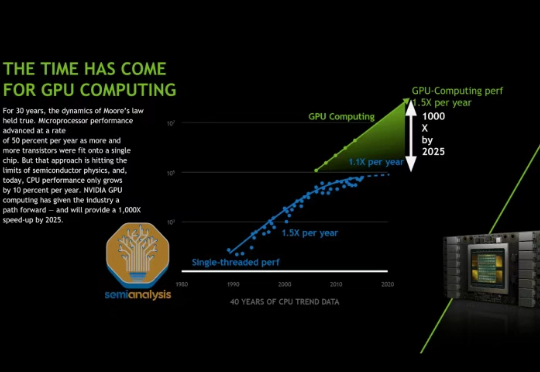
在我们去年 AI Scaling Laws article from late last year中,我们探讨了多层 AI 扩展定律如何持续推动 AI 行业向前发展,使得模型能力的增长速度超过了摩尔定律,并且单位 token 成本也相应地迅速降低。
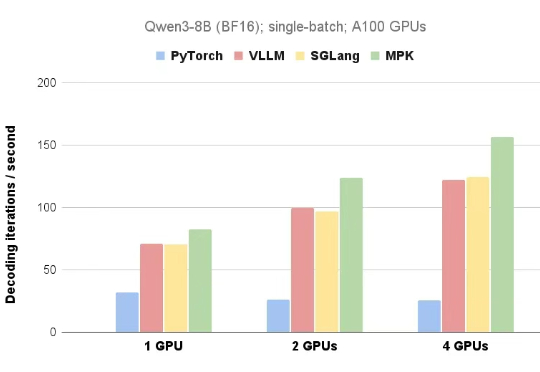
在 AI 领域,英伟达开发的 CUDA 是驱动大语言模型(LLM)训练和推理的核心计算引擎。
本期我们邀请到了萌友科技的 CEO 何嘉斌,一位从北京服装学院走出的产品设计师,以独特的女性视角和理工科思维,打造出“桌宠”Ropet——一款不以功能取胜、却以“无用之美”打动人心的情感陪伴机器人。
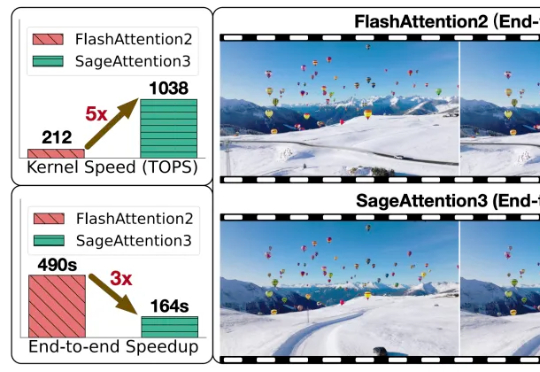
随着大型模型需要处理的序列长度不断增加,注意力运算(Attention)的时间开销逐渐成为主要开销。
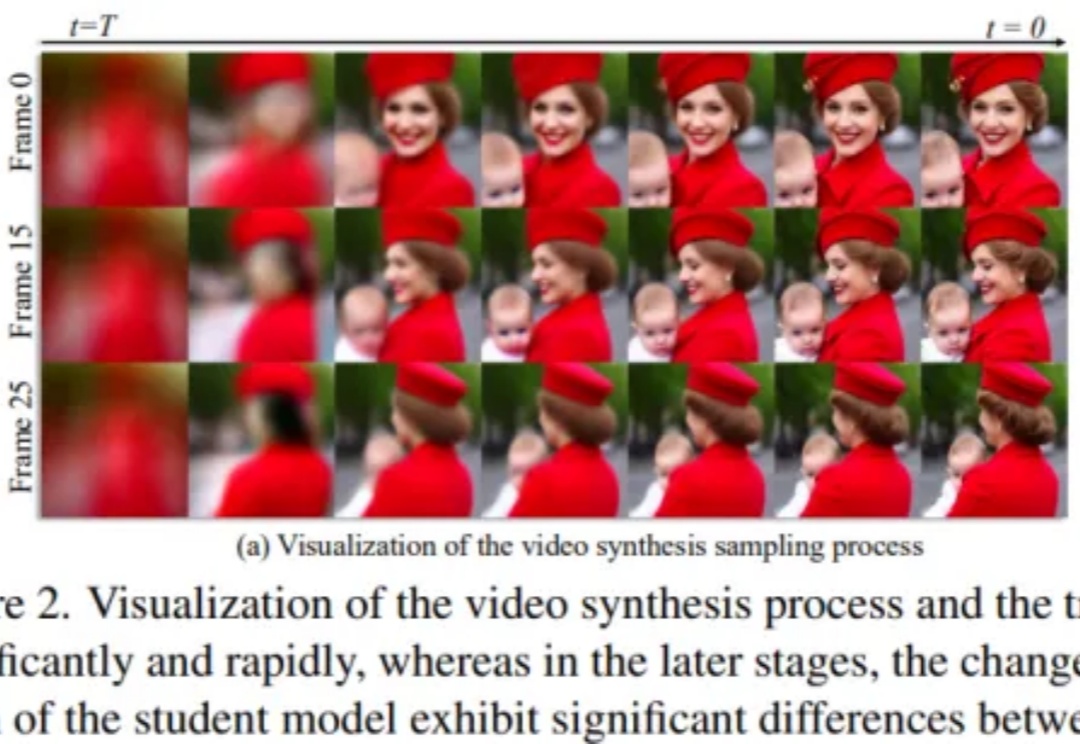
扩散模型在视频合成任务中取得了显著成果,但其依赖迭代去噪过程,带来了巨大的计算开销。尽管一致性模型(Consistency Models)在加速扩散模型方面取得了重要进展,直接将其应用于视频扩散模型却常常导致时序一致性和外观细节的明显退化。
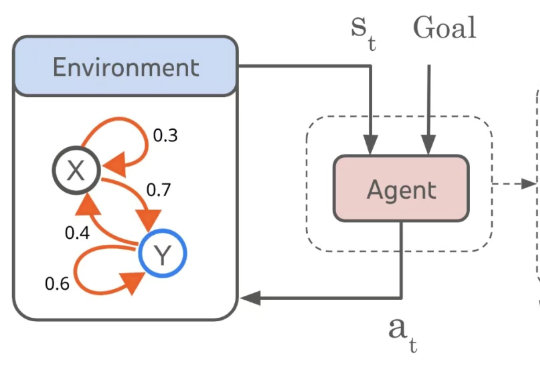
越通用,就越World Models。 我们知道,大模型技术爆发的原点可能在谷歌一篇名为《Attention is All You Need》的论文上。
Transformer已满8岁,革命性论文《Attention Is All You Need》被引超18万次,掀起生成式AI革命。Transformer催生了ChatGPT、Gemini、Claude等诸多前沿产品。更重要的是,它让人类真正跨入了生成式AI时代。