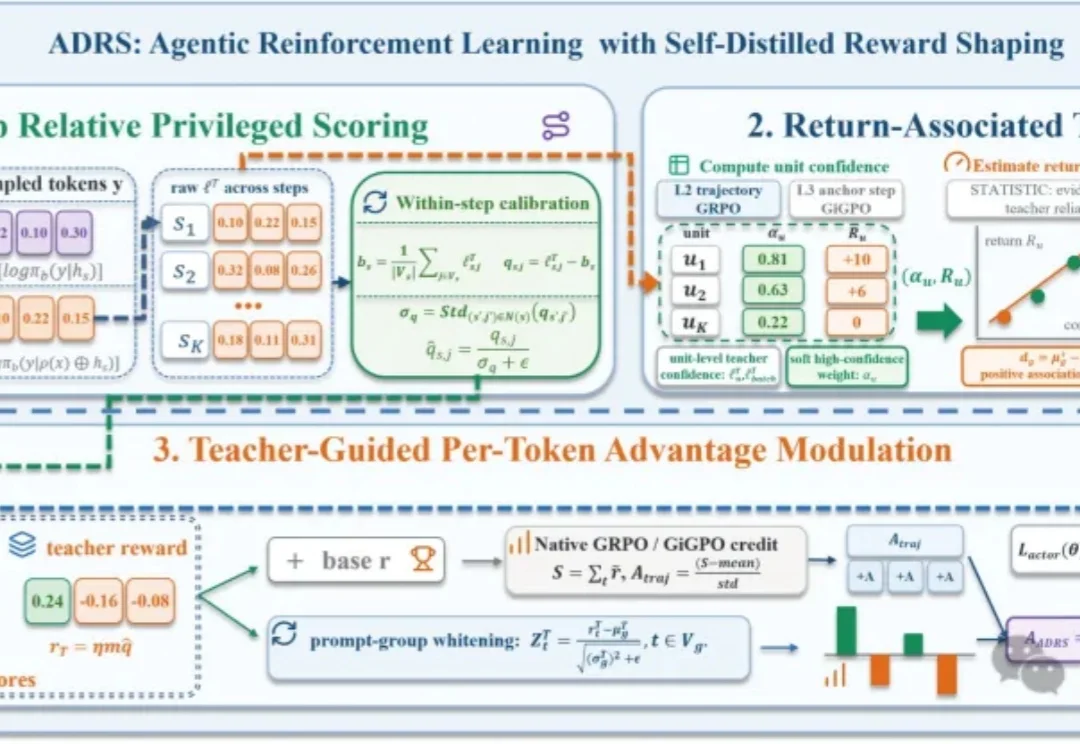
3B模型成功率94.5%!Token级奖励打开长链路智能体训练新思路
3B模型成功率94.5%!Token级奖励打开长链路智能体训练新思路多轮智能体任务只有一个终点奖励,但在一条包含搜索、工具调用和多轮决策的轨迹里,决定成败的往往是一个不起眼的查询词、动作或对象选择。
来自主题: AI技术研报
8572 点击 2026-09-15 13:35

 搜索
多轮智能体任务只有一个终点奖励,但在一条包含搜索、工具调用和多轮决策的轨迹里,决定成败的往往是一个不起眼的查询词、动作或对象选择。

清华大学AI Agent课题组提出加速扩散语言模型单元测试生成的框架DiffuTester,通过抽象语法树动态挖掘多个测试用例间的共享结构模式,在解码过程中保留相关token,在保持测试覆盖率的同时实现最高约2–3倍加速,相关论文已被EMNLP 2026接收。

趋境科技通过部署SGLang HiCache+Mooncake Store,将KV Cache从单机资源升级为集群级共享池化资源,支撑其日均产出超万亿Token的生产实践,KV Cache命中率稳定突破90%,并在生产环境中持续优化大规模推理集群的性能与稳定性。
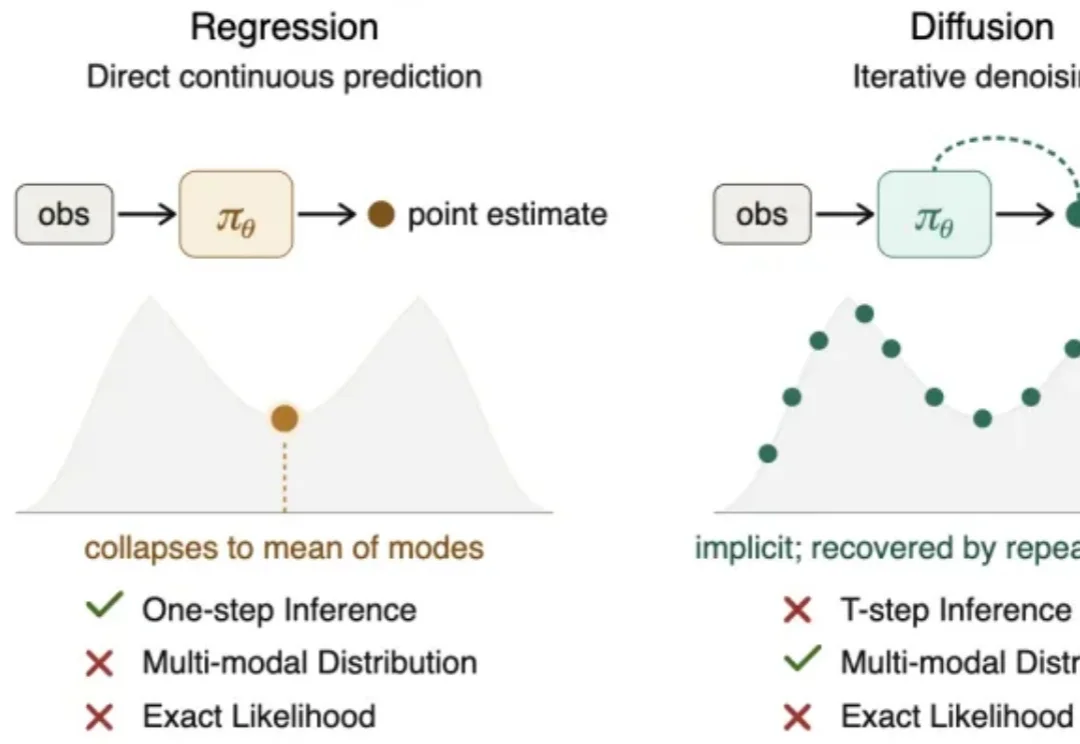
If I Had One Bet on Robot Learning, I’d Bet on Cross-Entropy. 大语言模型的成功揭示了一个适用于一维序列数据的清晰 Scaling Law:通过自回归训练,并采用交叉熵(cross-entropy)目标函数预测下一个 token 的概率分布,模型能够建模非常复杂的语义概率分布,并随着数据规模和模型规模的增长持续提升性能。
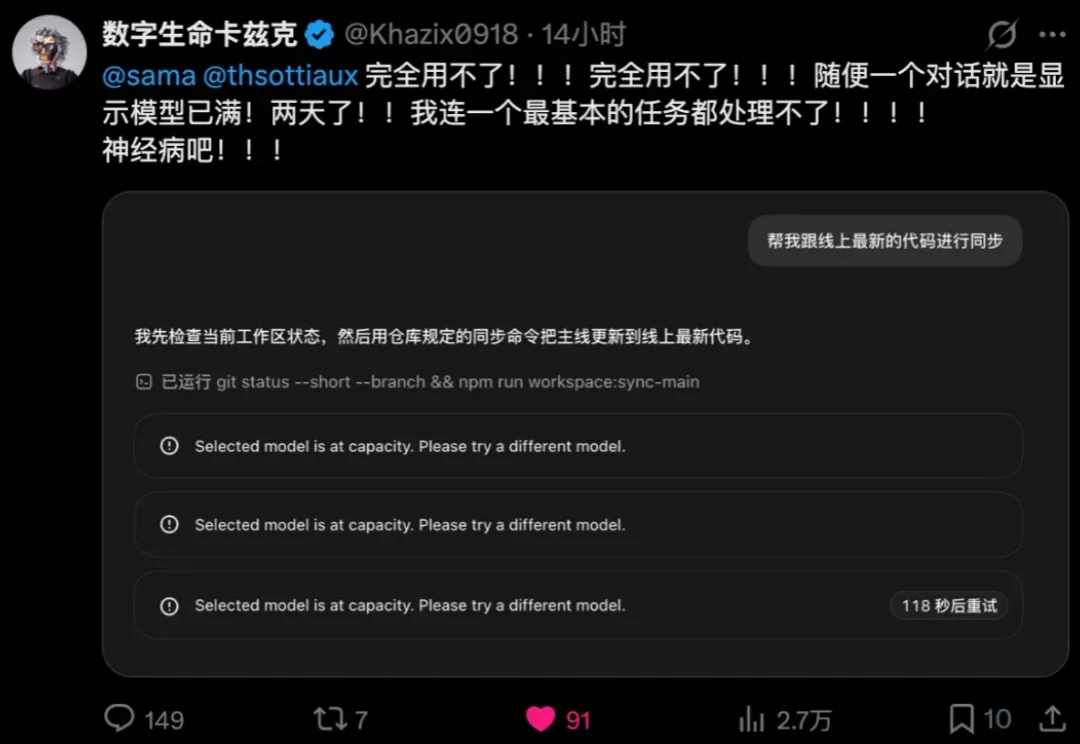
这几天,大家应该都用GPT-6 Astra了吧。
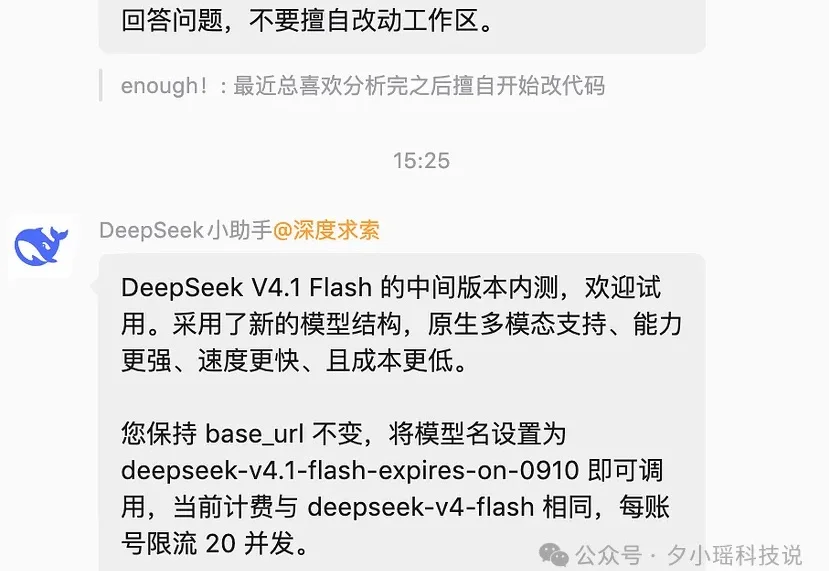
家人们,DeepSeek V4.1 Flash 开启内测了。
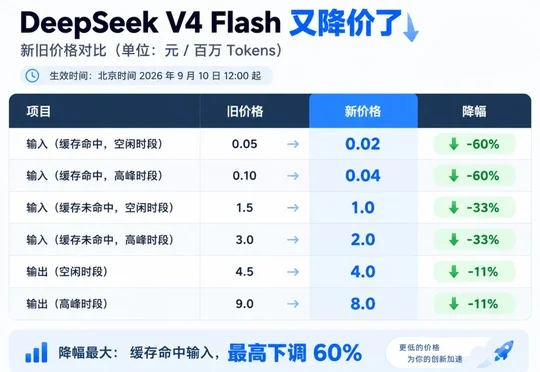
DeepSeek Flash系列自明日中午起降价,闲时缓存、输入和输出价格分别降至每百万Token 0.02元、1元和4元,新模型DeepSeek v4.1 Flash也已上线。
发力算电协同Token工厂,已融资5轮。
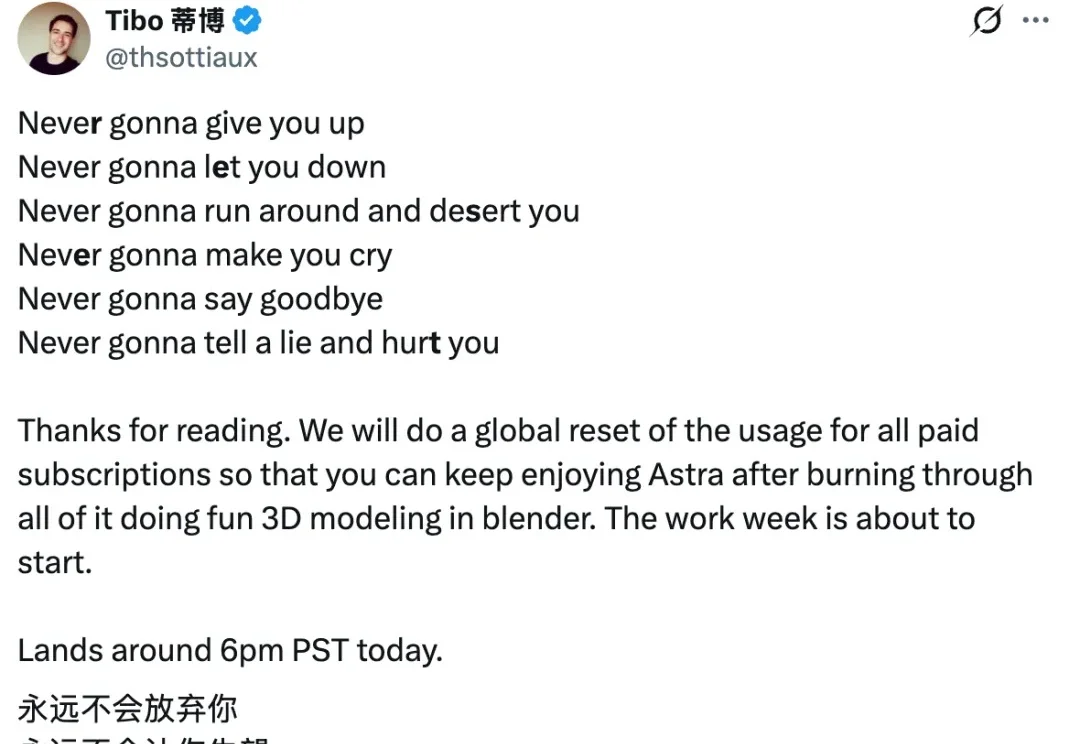
赛博义父Tibo,又来给大家送温(重)暖(置)了!!
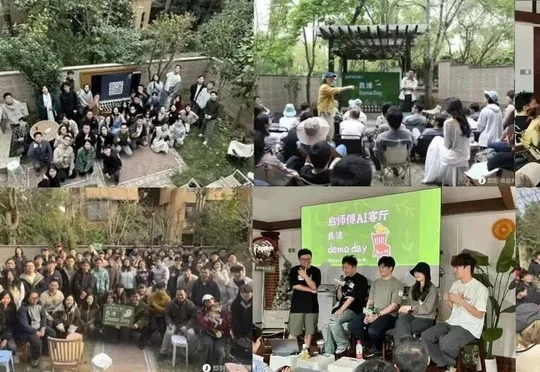
杭州自9月20日起向35家市级大学生创业园每人发放一张含1万积分的千问办公token卡,这是千问办公接入Qwen3.8-Max一个月后杭州首次将算力帮扶平铺到个人,标志着其AI产业思路从支持做模型的企业转变为支持用模型的人。