
暂时不敢用deepseek写作了
暂时不敢用deepseek写作了DeepSeek刚出来的时候,确实把我惊到了。严密的推理,天马行空的想象,近乎无限的知识面,让我已经开始收拾铺盖准备给AI老爷腾地方。但随着使用增加,我发现,它的文风太有辨识度了。
来自主题: AI资讯
11033 点击 2025-03-14 10:21

 搜索
DeepSeek刚出来的时候,确实把我惊到了。严密的推理,天马行空的想象,近乎无限的知识面,让我已经开始收拾铺盖准备给AI老爷腾地方。但随着使用增加,我发现,它的文风太有辨识度了。
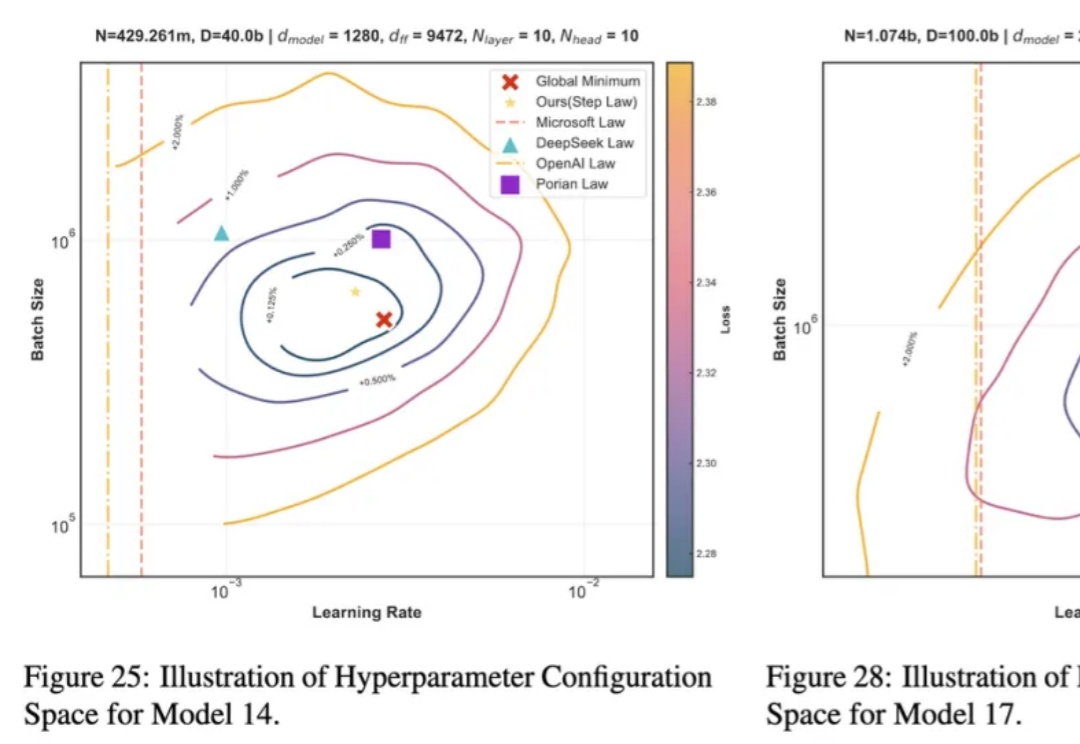
近年来,大语言模型 LLMs 在多种任务上的卓越表现已得到广泛认可。然而,要实现其高效部署,精细的超参数优化至关重要。为了探究最佳超参数的规律,我们开展了大规模的实证研究,通过在不同配置上进行网格搜索,我们揭示了一套通用的最优超参数缩放定律(Optimal Hyperparameter Scaling Law)。
不怕推理模型简单问题过度思考了,能动态调整CoT的新推理范式SCoT来了!
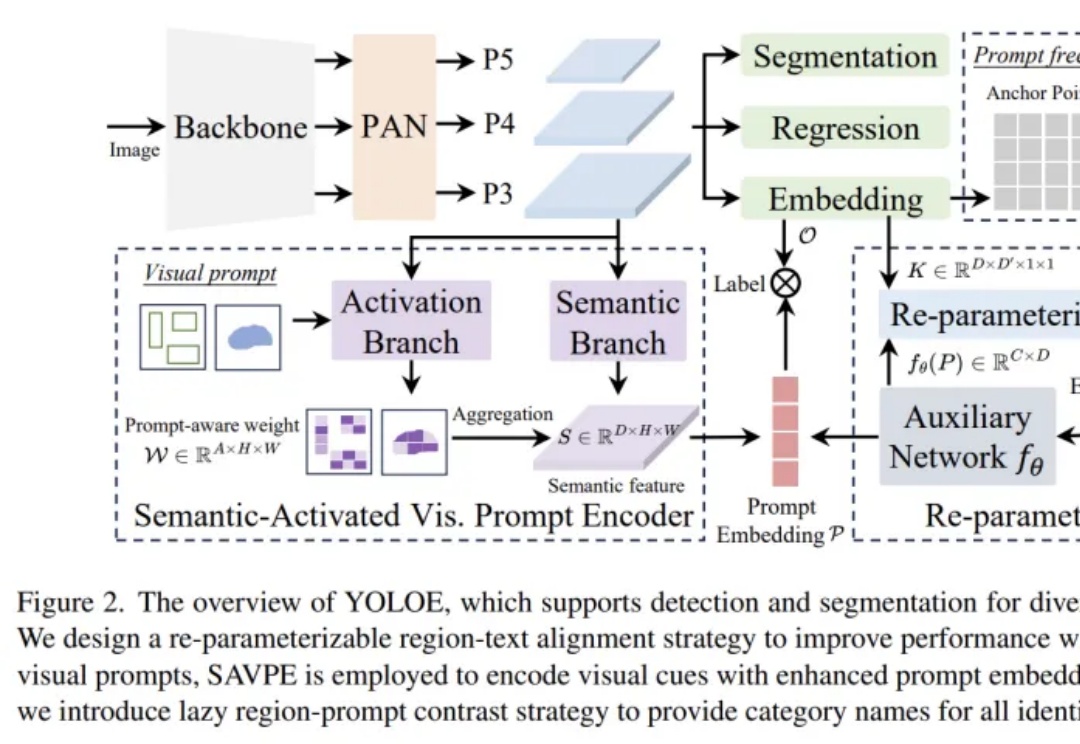
它能像人眼一样,在文本、视觉输入和无提示范式等不同机制下进行检测和分割。
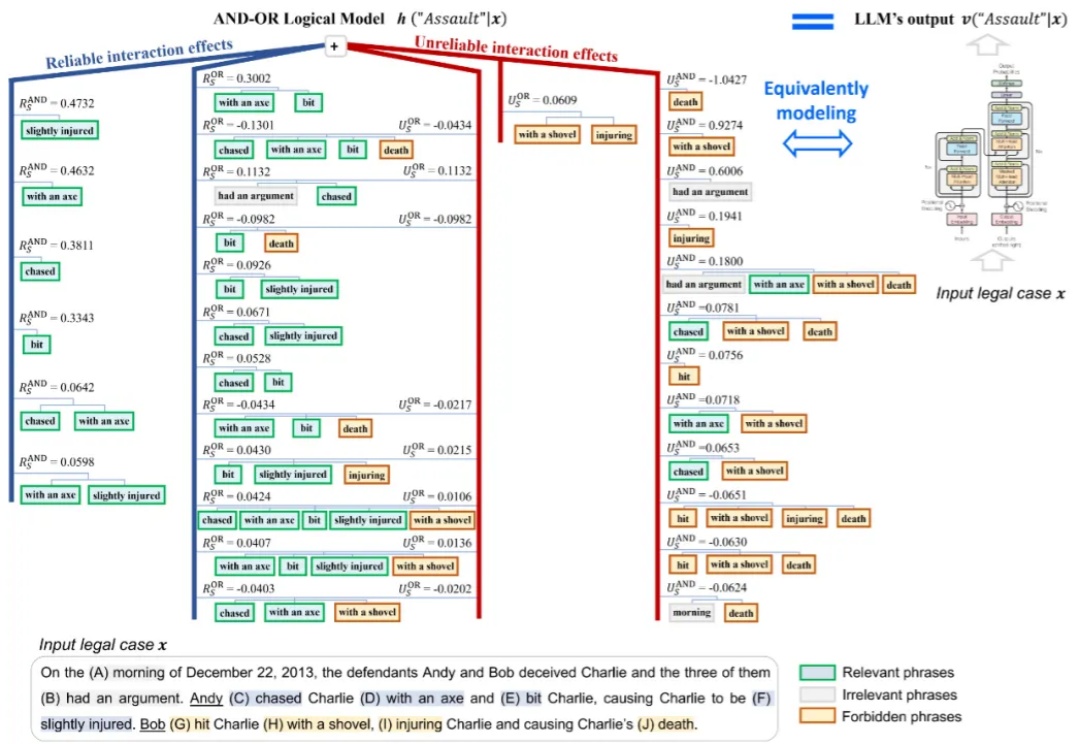
近些年,大模型的发展可谓是繁花似锦、烈火烹油。从 2018 年 OpenAI 公司提出了 GPT-1 开始,到 2022 年底的 GPT-3,再到现在国内外大模型的「百模争锋」,DeepSeek 异军突起,各类大模型应用层出不穷。
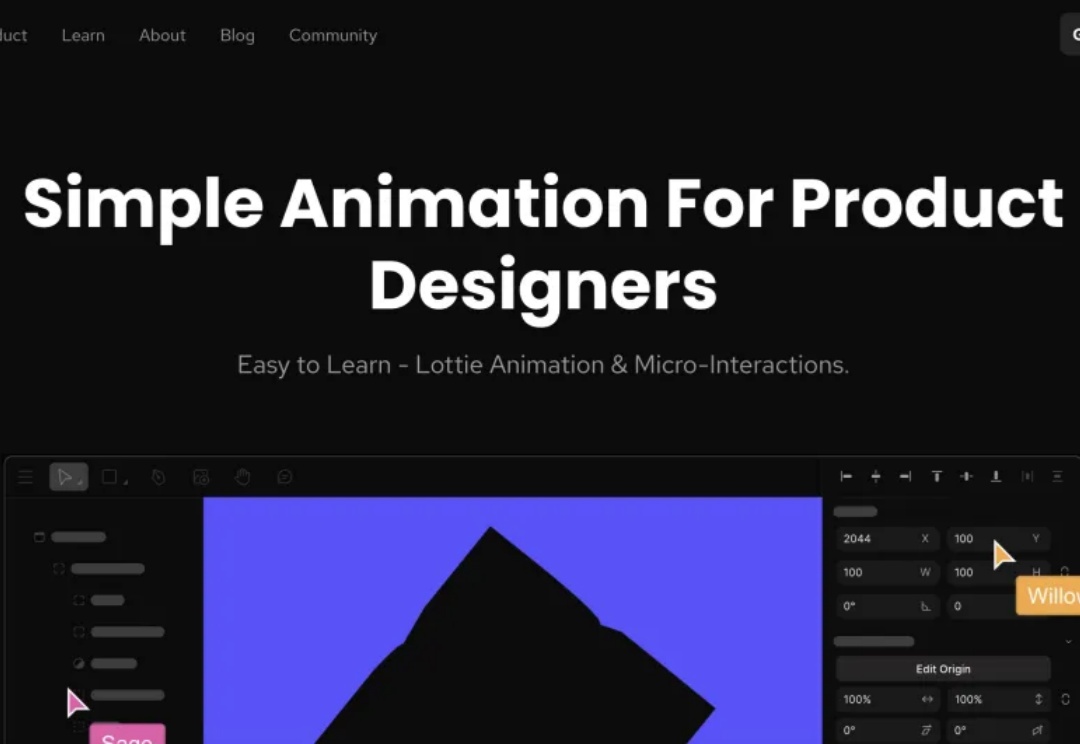
在当今数字产品设计领域,动画已不再是锦上添花,而是提升用户体验的关键要素。然而,对于大多数设计师来说,创建高质量的交互动画一直是一项挑战 —— 传统动画工具如 Adobe After Effects 或 Rive 不仅学习曲线陡峭,而且价格不菲。

Meta此举,或是要证明他们大规模投资AI基础设施不是在蛮干。
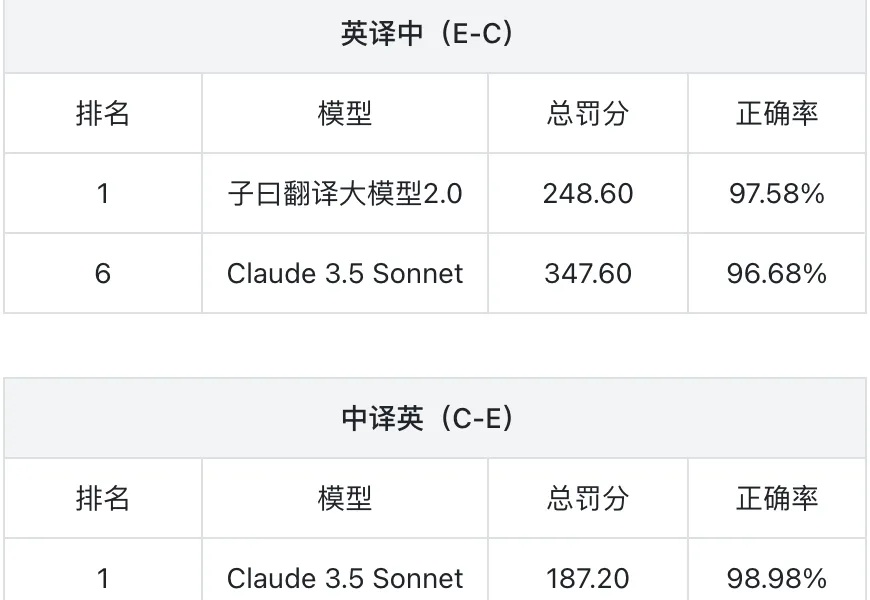
都说通用大模型轻松拿捏翻译,结果有人来掀桌了。
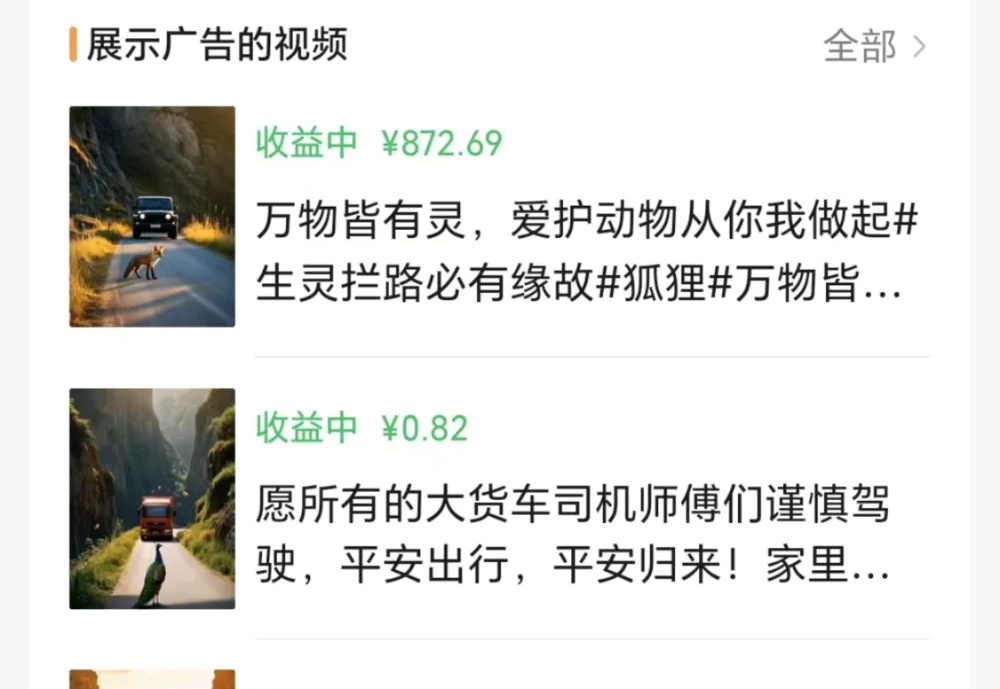
“发财了,一个视频回本,收益300多。”一位群友在群里发布了自己的视频号截图。另一位群友不语,只是发布了自己同话题的视频,显示收益800多。
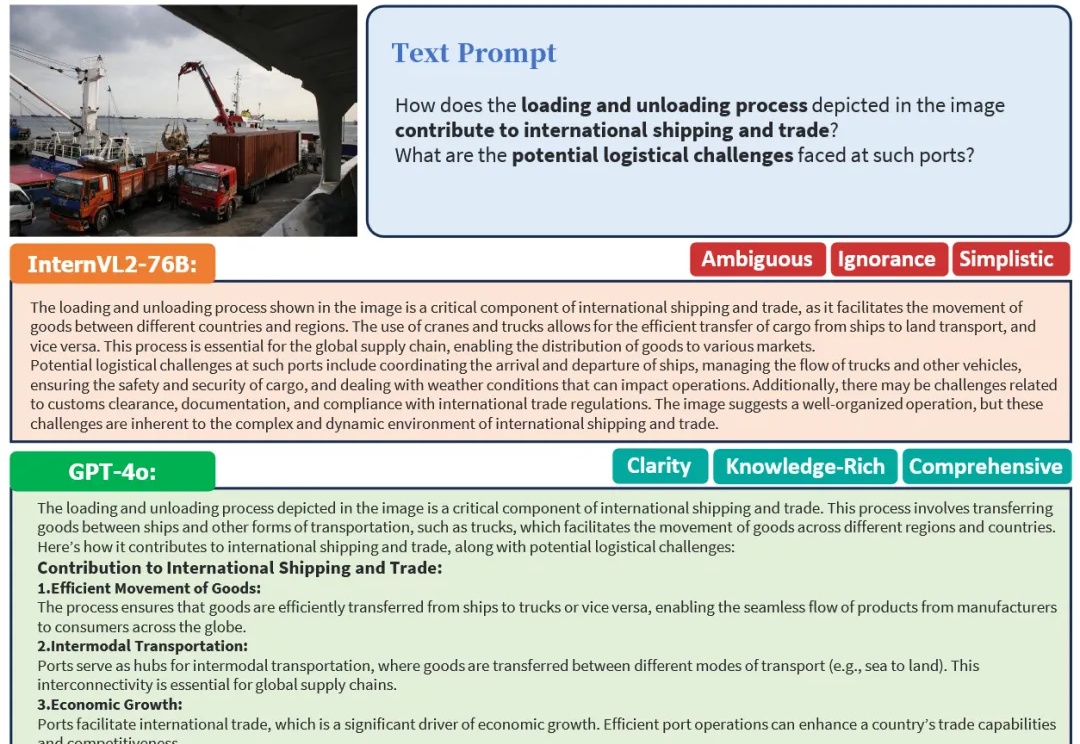
在实际应用过程中,闭源模型(GPT-4o)等在回复的全面性、完备性、美观性等方面展示出了不俗的表现。