视频世界模型终于不「失忆」了!Meta提出World-T³:把记忆写进参数,单卡20.6FPS实时生成
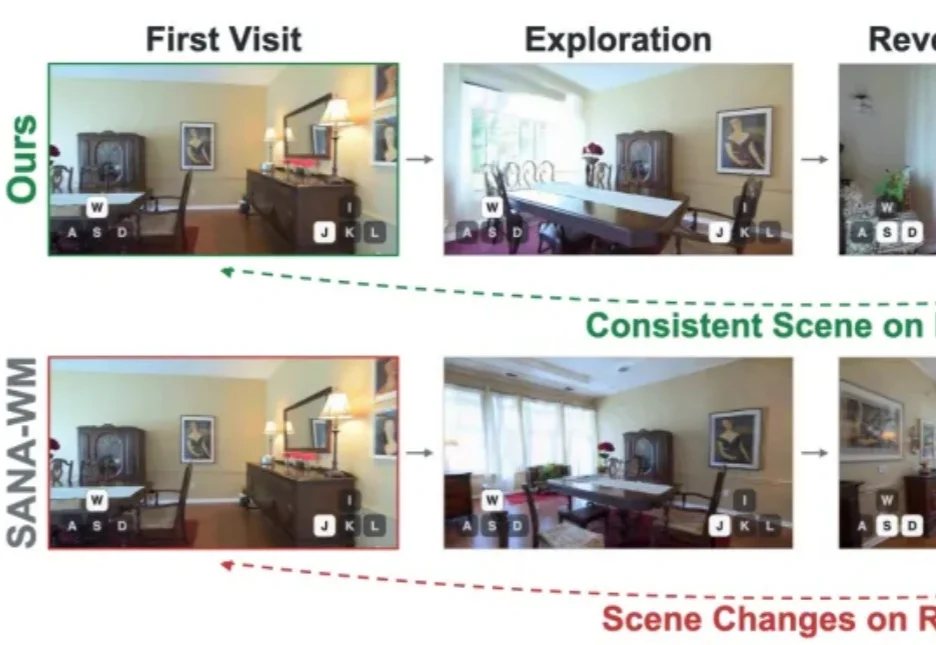
视频世界模型终于不「失忆」了!Meta提出World-T³:把记忆写进参数,单卡20.6FPS实时生成近两年,视频世界模型(video world model)成为生成式 AI 最受关注的方向之一。只需给定一张参考图和一段场景描述,模型就能根据用户输入的相机位姿或控制指令,逐帧生成出一个可以自由漫游的虚拟世界。
搜索
近两年,视频世界模型(video world model)成为生成式 AI 最受关注的方向之一。只需给定一张参考图和一段场景描述,模型就能根据用户输入的相机位姿或控制指令,逐帧生成出一个可以自由漫游的虚拟世界。
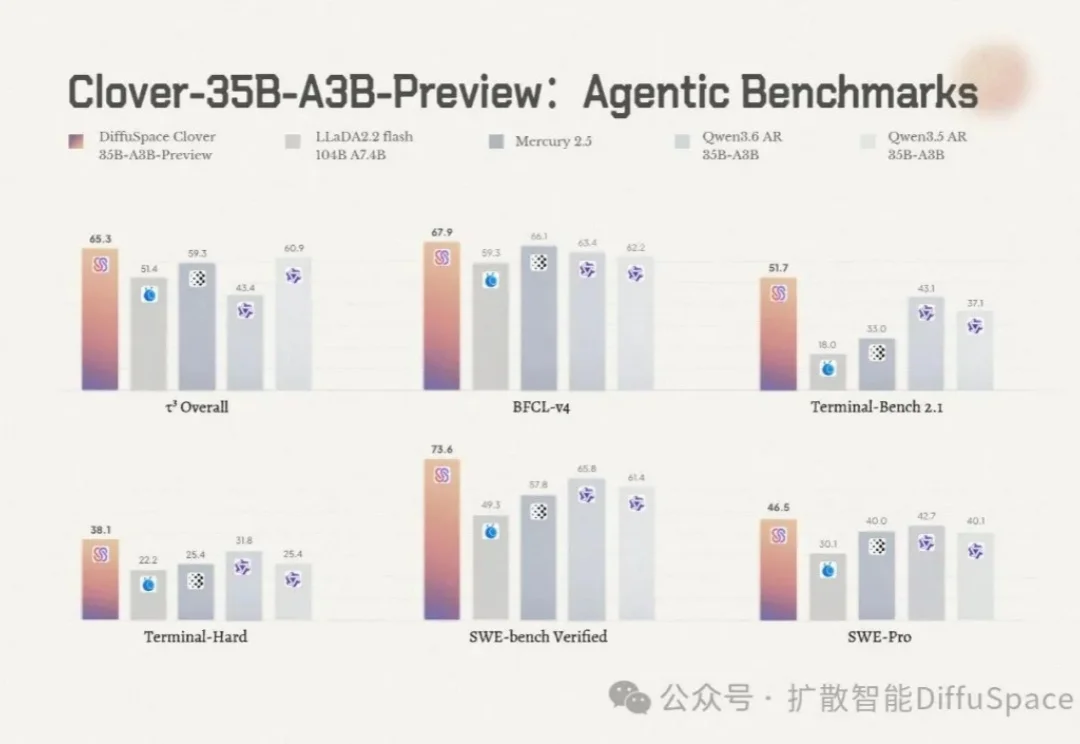
今天,我们正式推出 DiffuSpace Clover(三叶)的第一个版本 35B-A3B-Preview。
Jack Dorsey旗下Block研究团队Dessa尝试剔除文字训练、直接实现语音到语音交互,xAI的Grok Voice 3.0与OpenAI的GPT-Live则加速实时语音AI商用,但文章指出其在信息核对、隐私与办公场景中仍难取代屏幕。
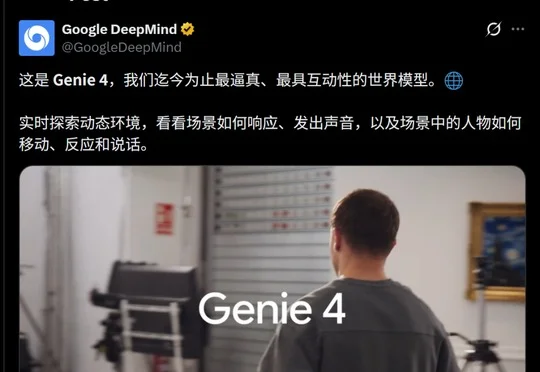
Google正式发布世界模型Genie 4,提升画面真实感、物理模拟、世界一致性与实时控制能力,并可生成同步环境音和互动对话,由Gemini引导智能体协助规划,展现其在游戏、VR及互动影游领域的潜力。
英伟达宣布向Meta投资30亿美元,并扩大Muse个人智能体及Muse系列模型合作,Meta同时计划募资950亿美元,以支撑AI基础设施和资本开支。
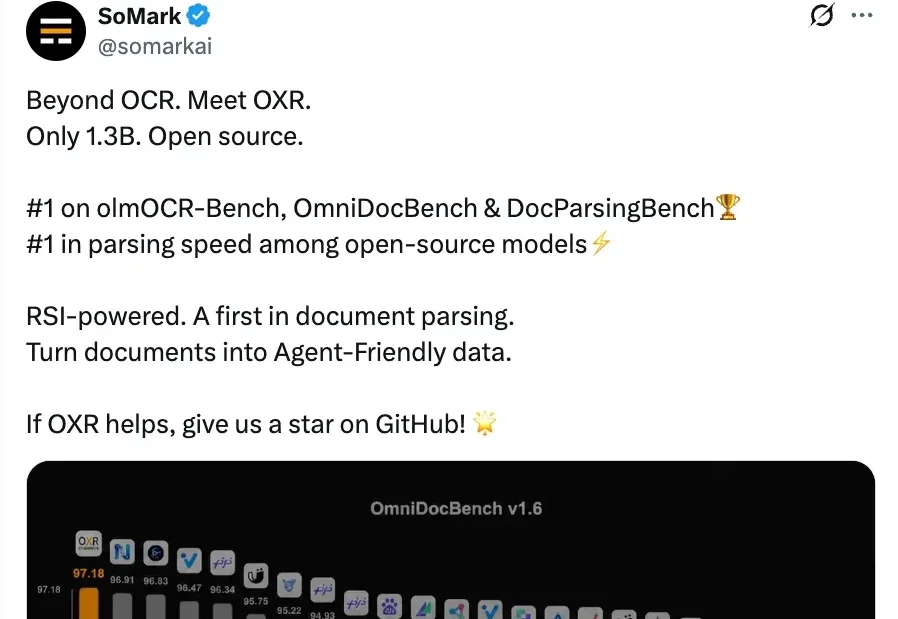
不er,RSI应用在OCR上,效果这么猛??
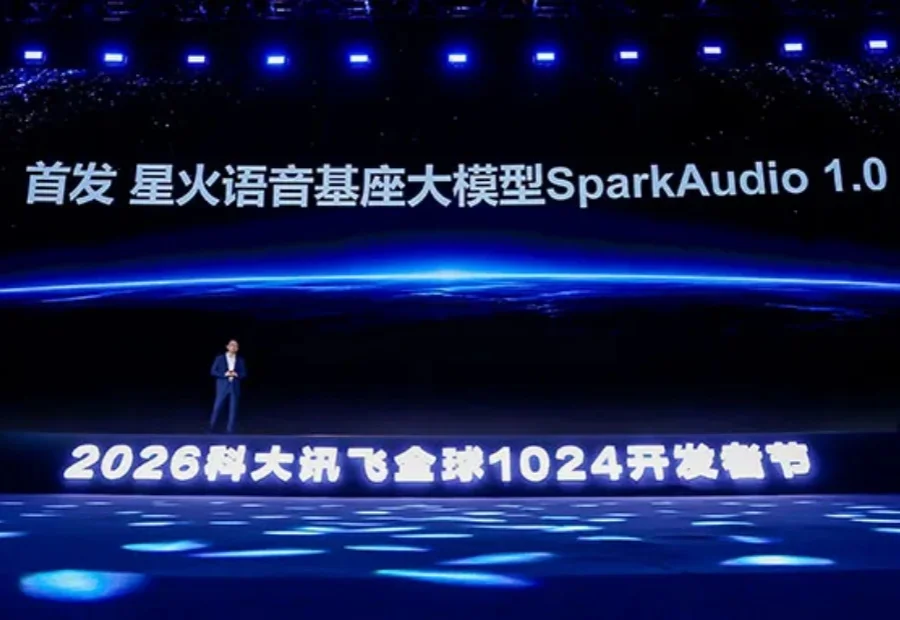
用全国产算力训练的底座,破局智能语音不可能三角。
在秦浩桐看来,AI 越强,值得研究的问题就越多。AI 聊天模型刚出现时,人们拿它聊天、解答困惑。后来发现它能写代码、处理任务,又开始希望它多做一点,最好能替自己把事情办完。模型的能力在长,人们的要求也在长。原来还没有人想到的用途,一旦变得可能,马上就会暴露出一批新的难题。
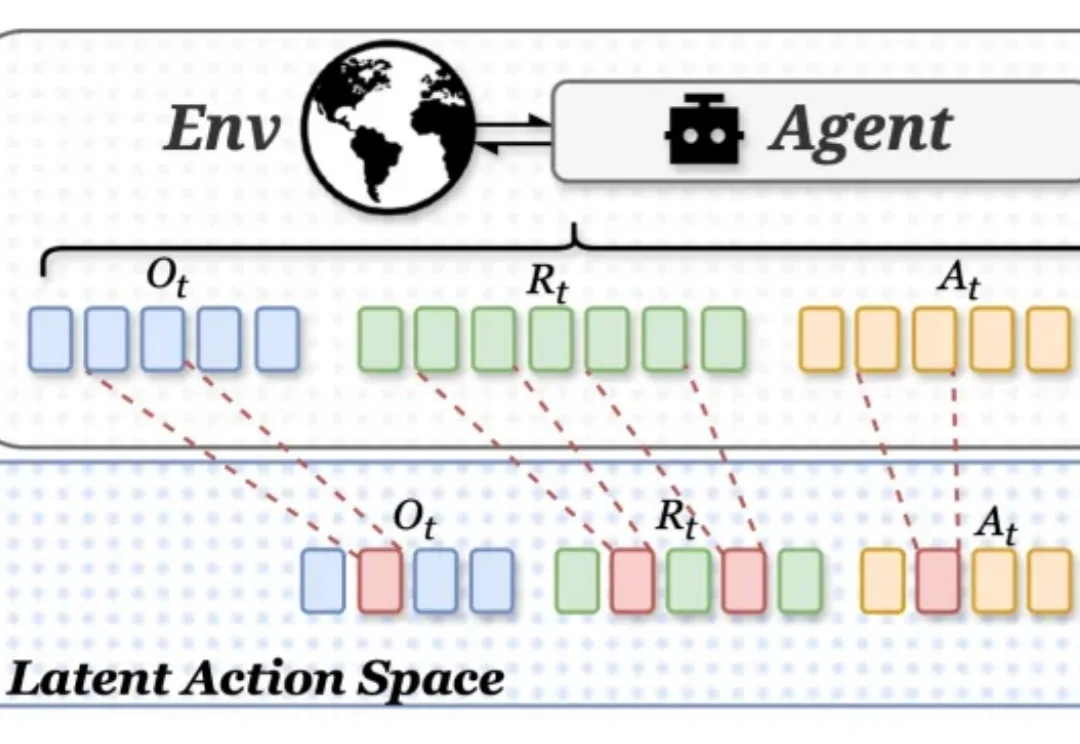
大模型Agent正在从简单问答,快速走向搜索、代码生成、网页操作和多轮工具调用。
Google DeepMind正式发布通用世界模型Genie 4,支持原生声音、实时对话与场景实时改写,单次连贯世界约维持2分钟,并由三款Gemini模型协同增强逻辑与物理模拟。