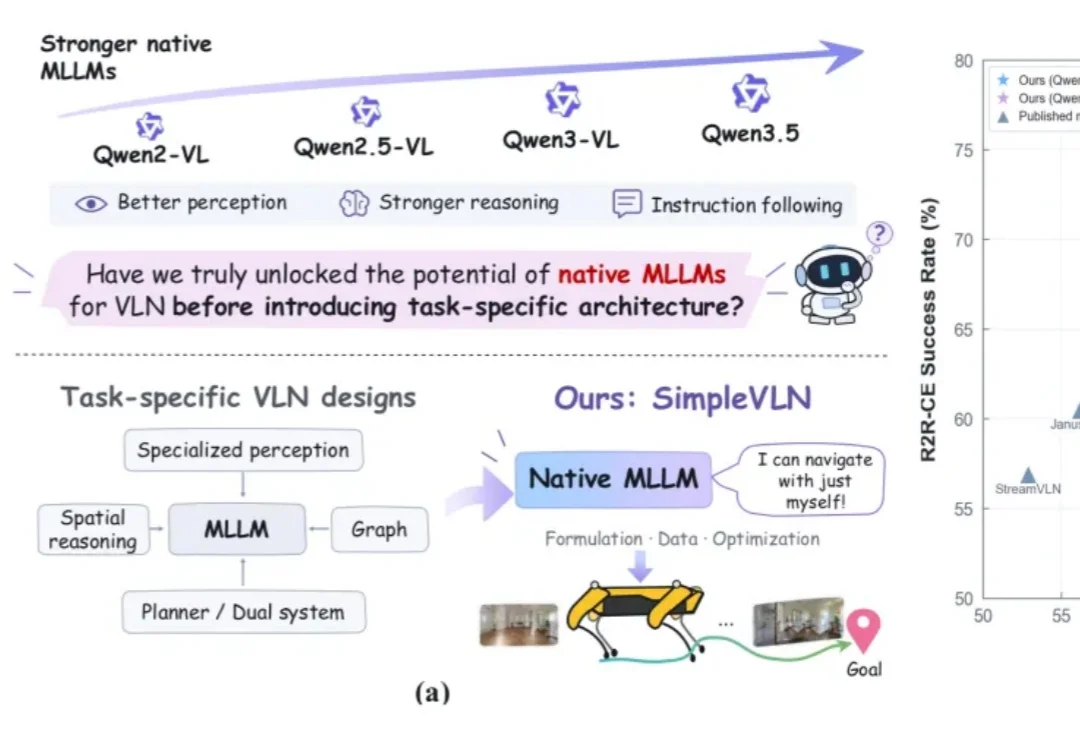
大道至简!复旦×南洋理工提出SimpleVLN,用原生MLLM刷新导航SOTA
大道至简!复旦×南洋理工提出SimpleVLN,用原生MLLM刷新导航SOTA设想这样一个场景:给机器人下达一句自然语言指令,让它穿过走廊、接连转弯,最终走进指定房间。视觉语言导航(VLN),需要让机器人结合沿途看到的画面,把人类的语言指令转化为一连串连续行动。
来自主题: AI技术研报
6476 点击 2026-10-30 10:03

 搜索
设想这样一个场景:给机器人下达一句自然语言指令,让它穿过走廊、接连转弯,最终走进指定房间。视觉语言导航(VLN),需要让机器人结合沿途看到的画面,把人类的语言指令转化为一连串连续行动。
一个充电器,一根缠成一团的线。
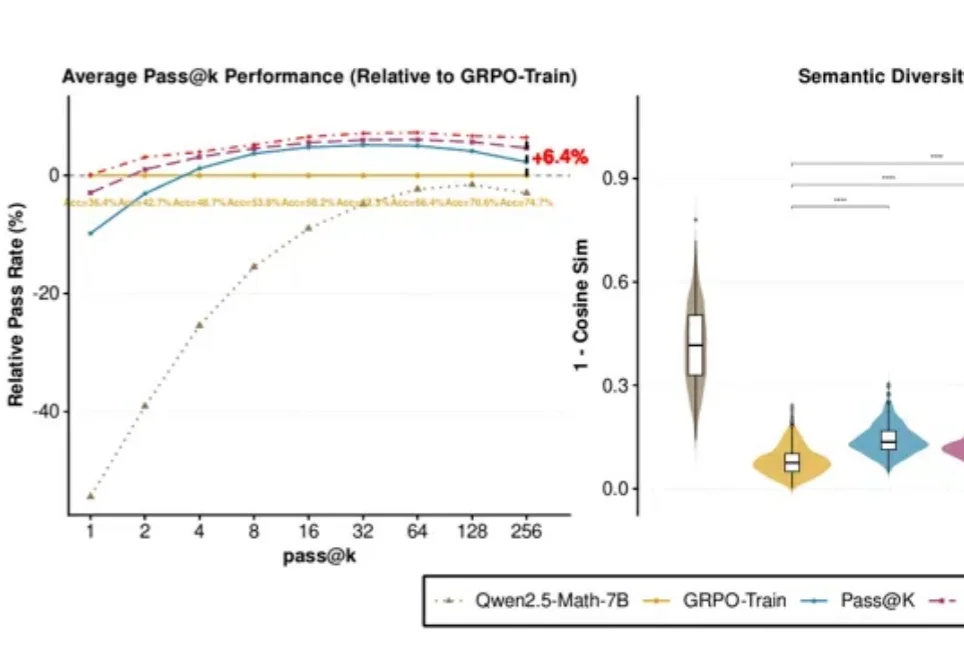
DeepSeek-R1等模型让人们看到了强化学习的潜力。但已有研究发现,模型答得更准,未必意味着能解出的题目更多。
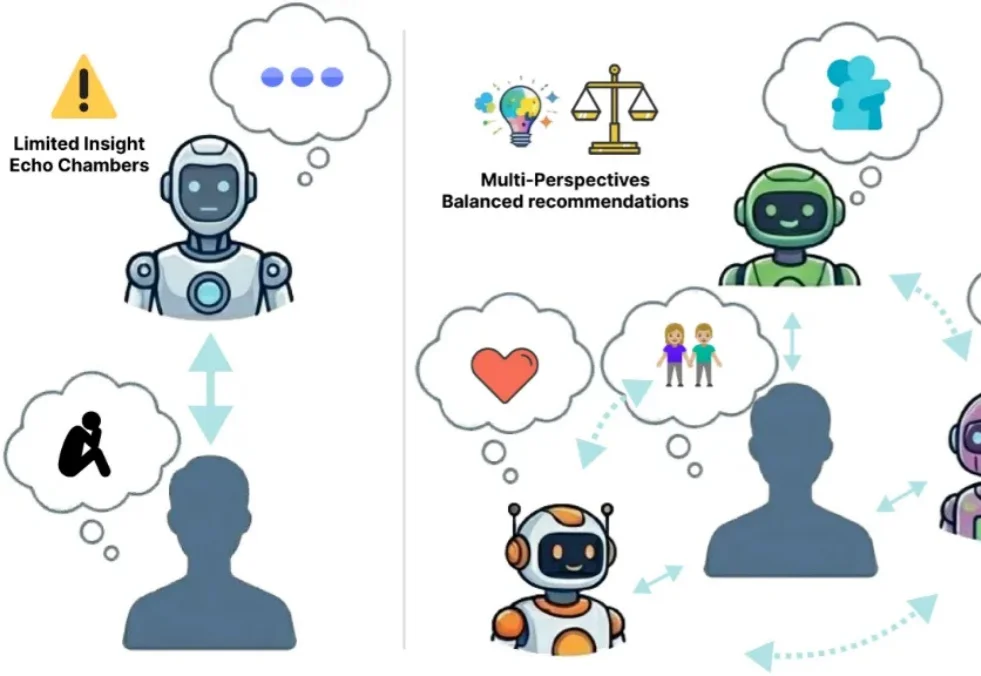
想象一下,你向几个 AI 倾诉最近的压力。
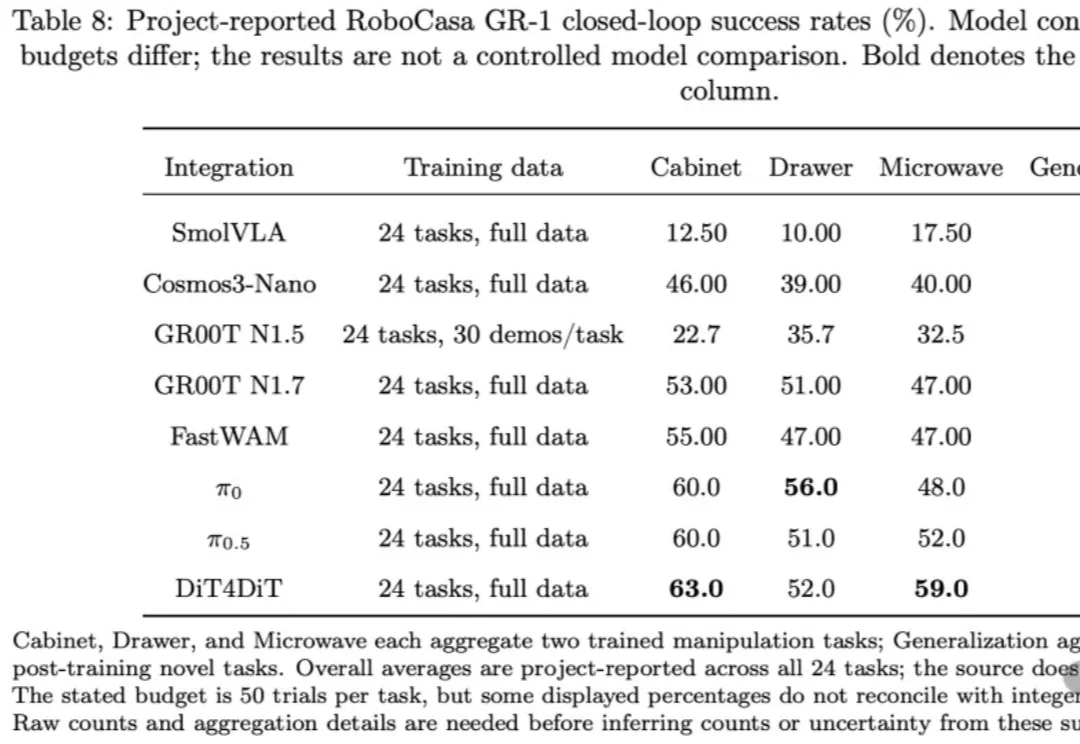
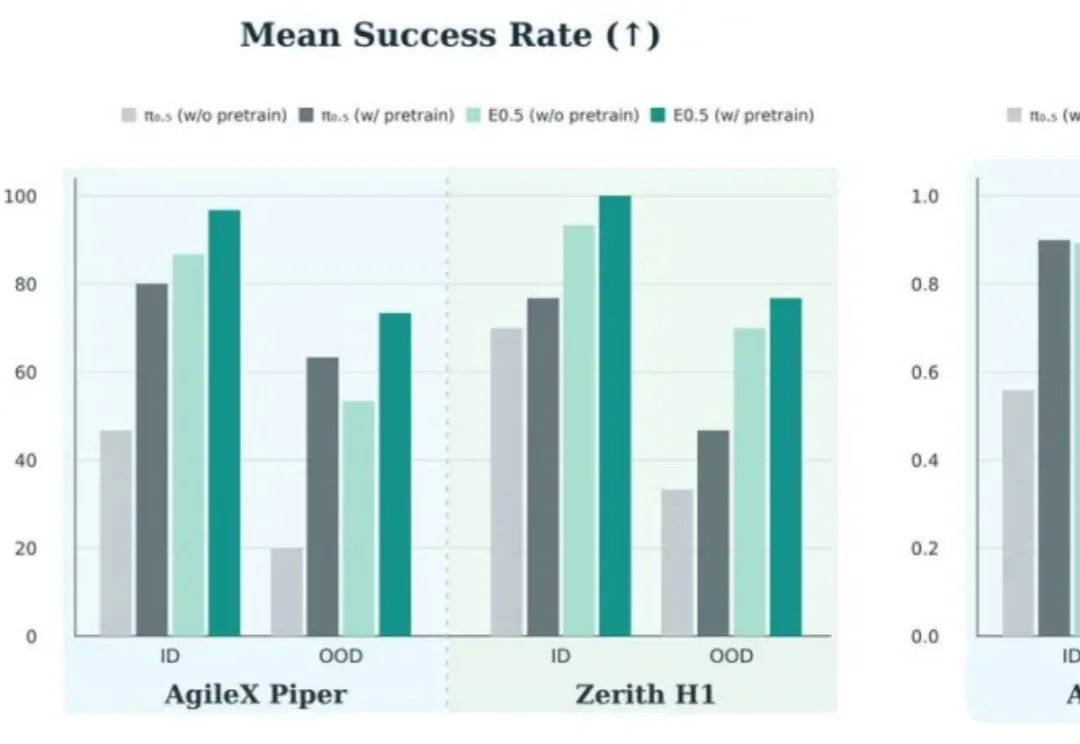
什么时候是具身智能的ChatGPT时刻?
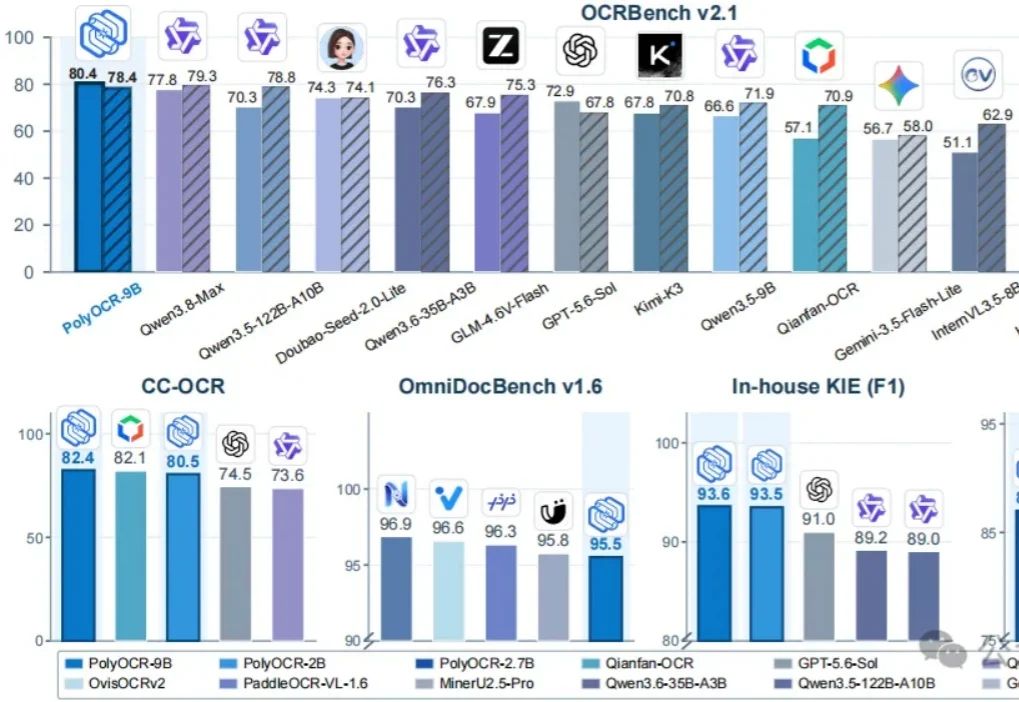
随着多模态大模型越来越强,OCR的短板反而逐渐明显。
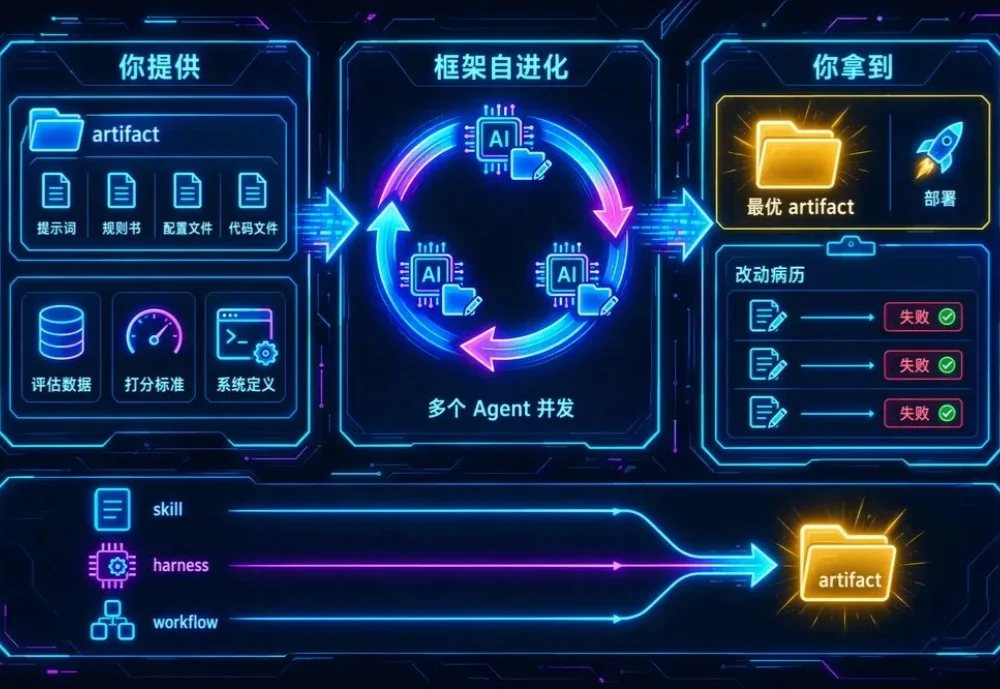
每个做 AI 系统的人都经历过这个阶段:效果上不去,又不知道往哪使劲——读轨迹、改 prompt、调配置,靠人一轮轮试,一试就是好几天。
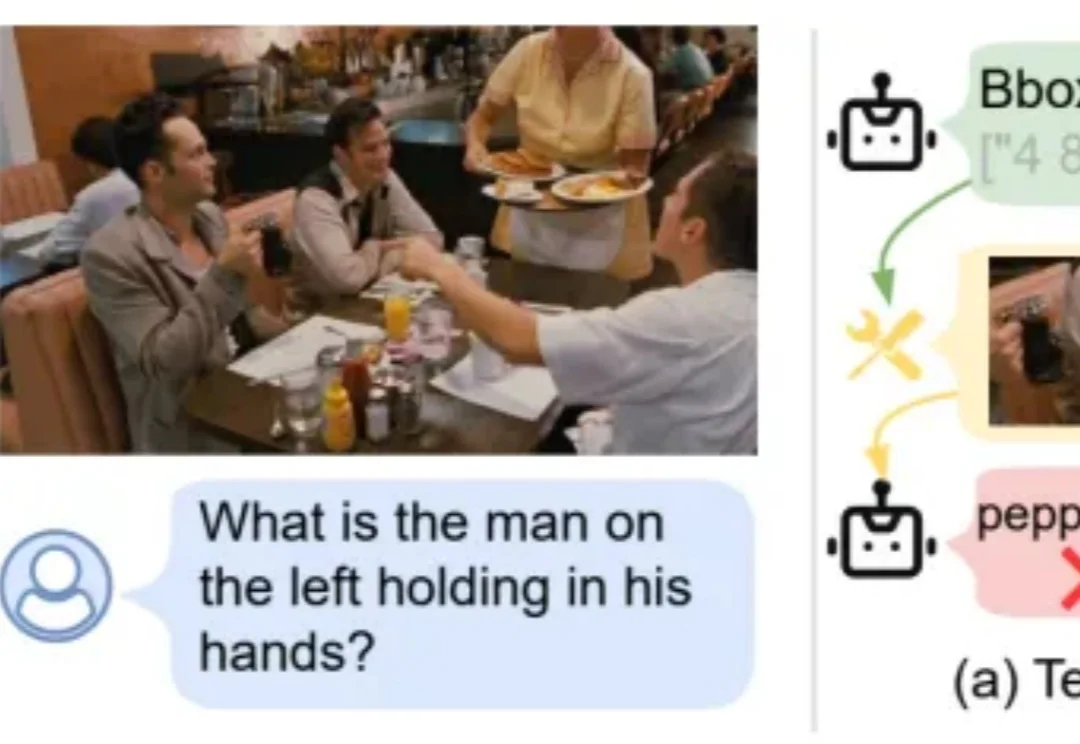
一张高清照片中,远处的手提包是什么颜色?一页票据里,某项费用到底是多少?面对这些问题,多模态大模型常常需要先找到相关区域,再放大查看。但如果第一步就框错了位置,后面的推理也可能跟着出错。视觉思维链让模型能够边看边想、调用工具寻找证据。不过,许多方法仍然像生成句子一样,把边界框坐标逐个写成文本 token。连续的空间位置,为什么要通过离散文字来表达?
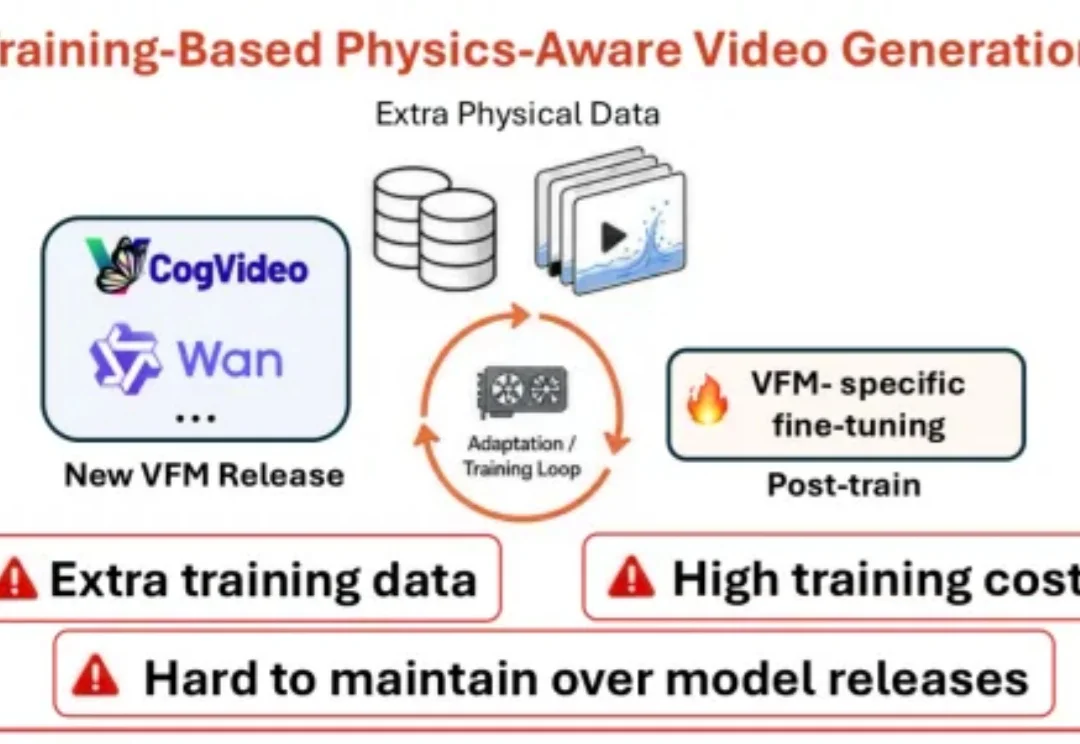
一颗梨在液体中快速旋转,周围的液体应该随之流动、飞溅;一个物体撞向水面,液体也应该产生与碰撞相对应的响应。
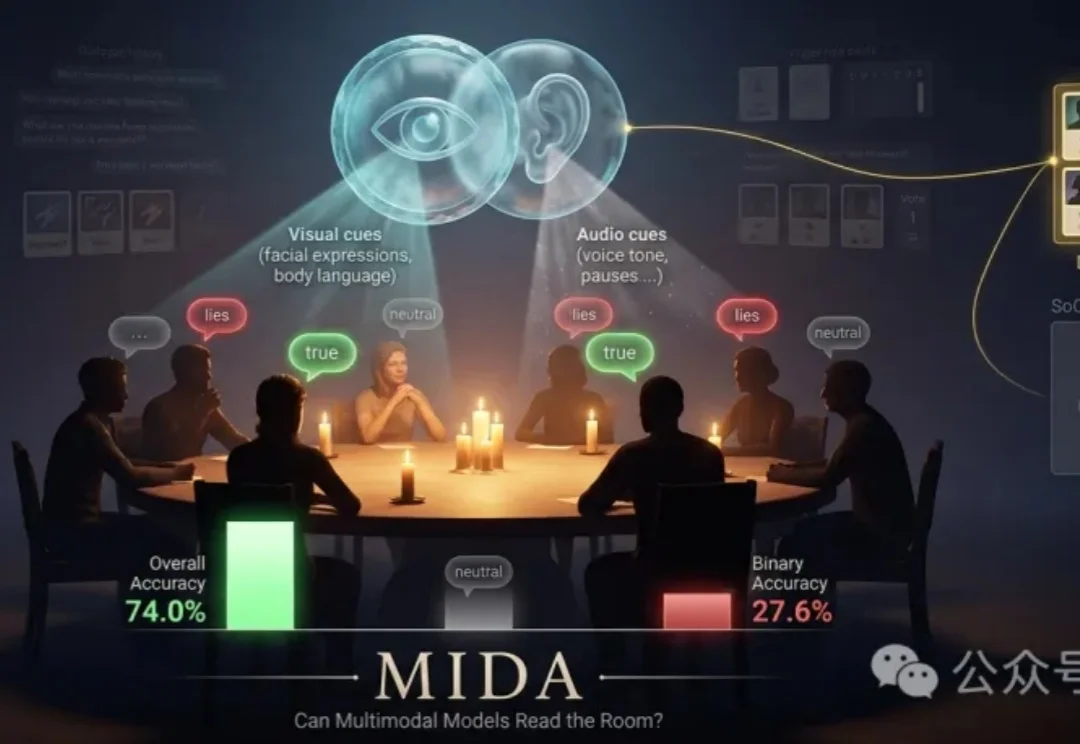
人类说一句「我不是狼」,多模态大模型既能看到表情,也能听见声音。但它真的知道这句话是真是假吗?