千万token下,比DeepSeek式稀疏注意力再快22倍
千万token下,比DeepSeek式稀疏注意力再快22倍如今,百万 token 上下文已经从卖点变成了标配。4 月,DeepSeek-V4 把 1M 上下文定为所有官方服务的默认规格;8 月,智谱发布的 GLM-5.3-Flash 同样支持 1M 上下文,并首次在 GLM 系列中引入稀疏注意力与线性注意力的混合架构。这些模型背后有一个共同的选择:让每个 query 不再看遍所有历史 token,只挑出少数最相关的去「看」。
搜索
如今,百万 token 上下文已经从卖点变成了标配。4 月,DeepSeek-V4 把 1M 上下文定为所有官方服务的默认规格;8 月,智谱发布的 GLM-5.3-Flash 同样支持 1M 上下文,并首次在 GLM 系列中引入稀疏注意力与线性注意力的混合架构。这些模型背后有一个共同的选择:让每个 query 不再看遍所有历史 token,只挑出少数最相关的去「看」。
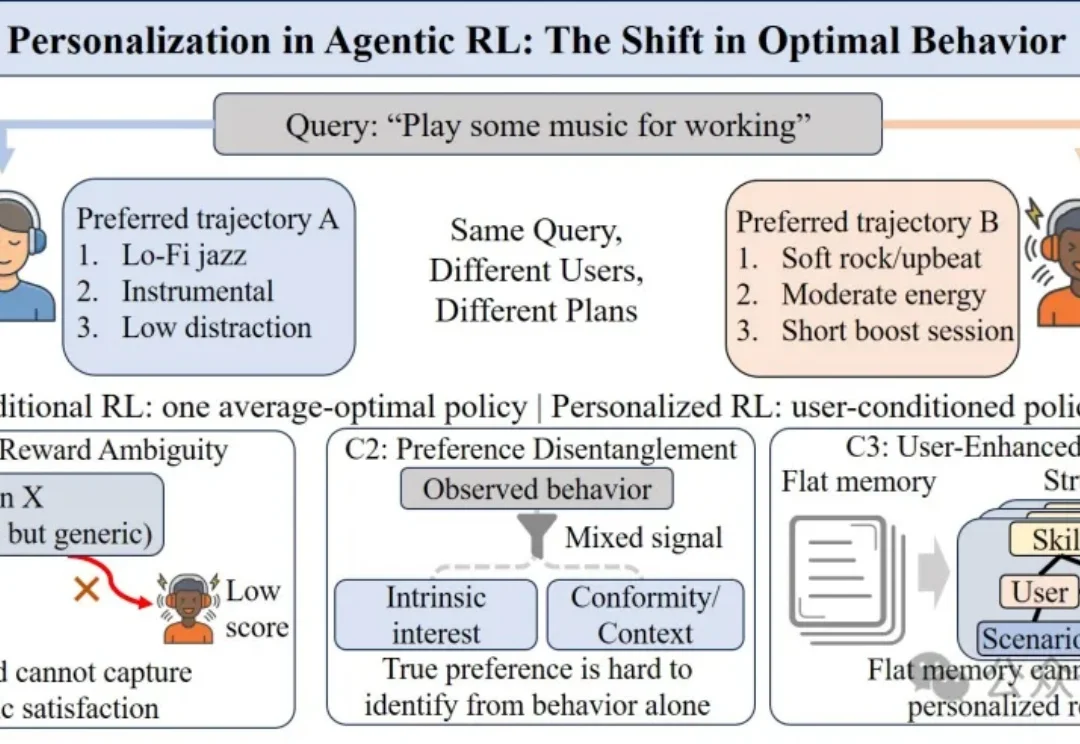
当个性化Agentic RL遇上现实用户平台场景时,一直存在一个常见难点:面对同样的query,不同用户往往偏好不同的规划策略、工具调用和最终表达。
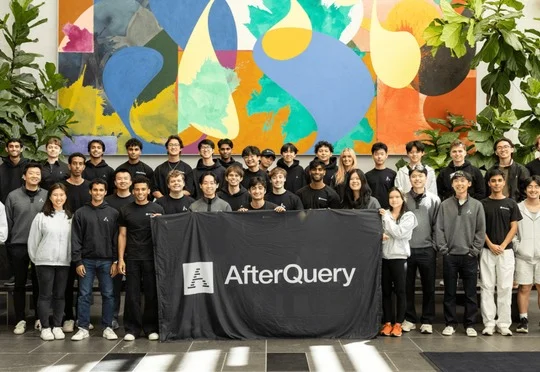
AI数据创企AfterQuery估值达32亿美元,成为Y Combinator史上从创立到成为独角兽速度最快的企业,此前其A轮估值仅为3亿美元。
由两名00后大学生创办的美国AI训练数据公司AfterQuery五个月内估值从3亿美元升至32亿美元,其数据已用于英伟达Nemotron 3 Ultra模型训练,并与Thinking Machines Lab、Legora及部分中国AI实验室合作。
从 2D 像素到 3D 场景 Query,影溯正在尝试把三维内容生产推向可规模化调用的新阶段。
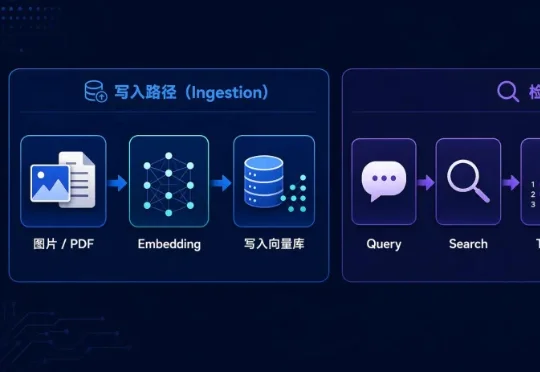
多模态 Agent 的记忆系统,过去很容易被理解成一个升级版 RAG:图片、图表、PDF 进来之后,先抽取内容、做 embedding、写进向量库;用户提问时,再用 query 做检索,把命中的top-k图片、文档页或图表一并塞进上下文,再交给多模态模型回答。整个过程中,所有原始模态信息都会不加选择的塞给大模型。
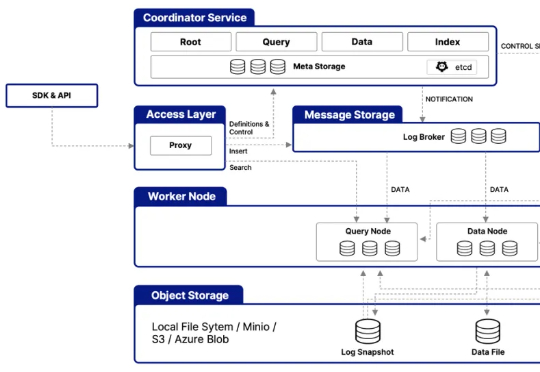
在架构层面,Milvus 2.6 大幅简化系统架构,整合多个核心组件 —— 例如将原有的 Coordinator 组件(含 RootCoord、QueryCoord、DataCoord)统一整合为 MixCoord,并将 IndexNode 与 DataNode 合并为单一组件。这些调整不仅降低了系统复杂度,更显著提升了系统的可维护性与横向扩展性。
在开发DeepResearch时,生成多样化的查询 (query) 是一个关键细节。我们在开发时会在至少两处遇到这个问题。
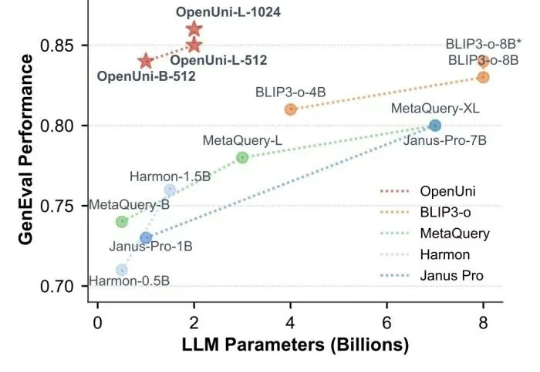
随着 GPT-4o 展现出令人印象深刻的多模态能力,将视觉理解和图像生成统一到单一模型中已成为 AI 领域的研究趋势(如MetaQuery 和 BLIP3-o )。
在生成式 AI 重塑搜索形态的当下,Perplexity 正以“答案”为核心,重构信息入口。它不是聊天机器人,也不是传统搜索引擎,而是一种 “认知界面”——通过自然语言对话,为用户提供可验证、可引用的真实答案 。