NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源
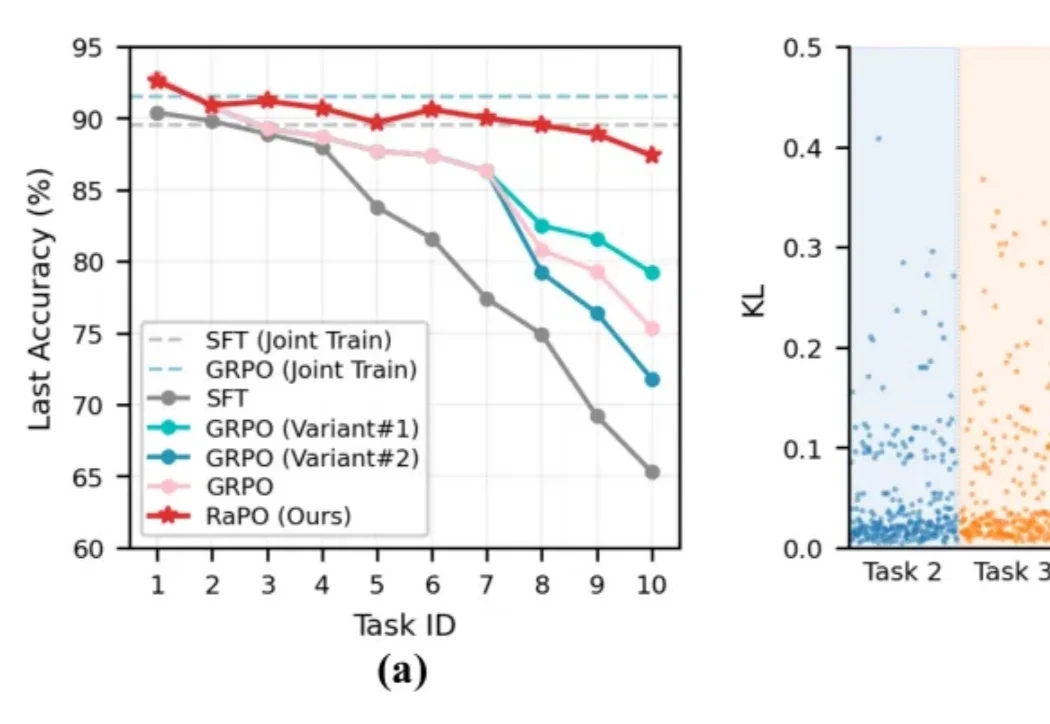
NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。
来自主题: AI技术研报
7936 点击 2026-11-05 17:01