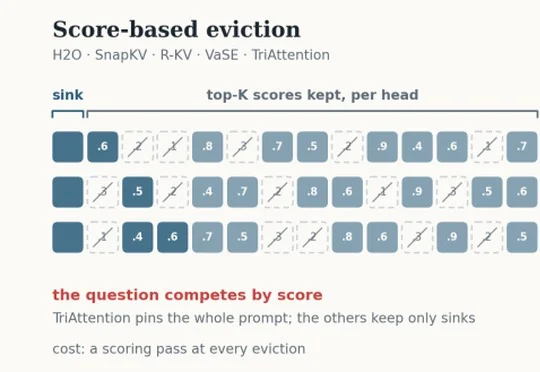
KV Cache不用「精挑细选」?随机删除媲美最强基线,推理吞吐最高再提43%
KV Cache不用「精挑细选」?随机删除媲美最强基线,推理吞吐最高再提43%大模型越来越会 “想”,也越来越能把 GPU 显存 “想满”。 在数学、科学问答和代码生成等任务中,reasoning model 往往会生成数千乃至数万 token 的长推理链。随着生成持续进行,每
来自主题: AI技术研报
8416 点击 2026-09-20 11:05

 搜索
大模型越来越会 “想”,也越来越能把 GPU 显存 “想满”。 在数学、科学问答和代码生成等任务中,reasoning model 往往会生成数千乃至数万 token 的长推理链。随着生成持续进行,每
Z Potentials独家获悉,LiberAI完成新一轮数亿元Pre-A++轮融资,投资方包括中关村科学城、达晨财智、高信资本、华映资本等。5个月内,LiberAI已获得红杉中国、真格基金、美团龙珠、顺为资本等顶级机构的连续押注,累计融资超十亿。
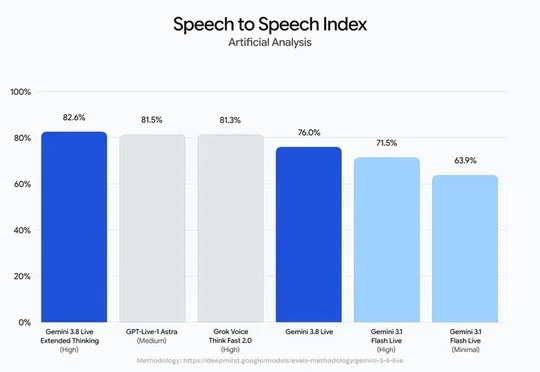
谷歌发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 两款实时语音模型,后者支持后台异步推理与工具调用以解决语音 Agent 在任务执行中的沉默问题,两款模型已在 Gemini API 和 Google AI Studio 向开发者开放。
Z Potentials独家获悉,亿格云已完成近亿元人民币B+轮融资。本轮由MTR Lab与北极光创投联合投资,航行资本担任独家财务顾问。
RunningHub推出开源的H3 Lightning加速方案,在保留BF16满血精度的前提下使MiniMax H3视频生成速度提升约12倍,依托RH后训练加速模型、SageAttention2等工程优化并针对无NVLink的PCIe多卡环境调优,目前已全部开源至GitHub,支持创作者本地部署。
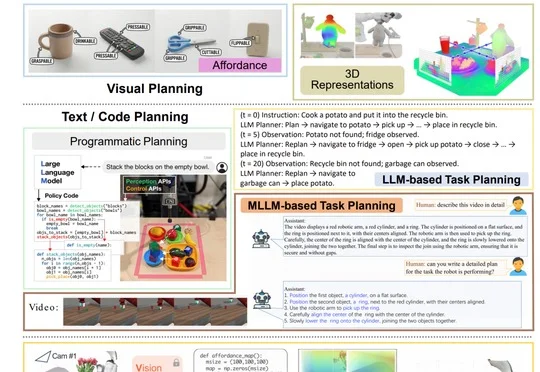
过去几年,机器人操作领域几乎被一批新概念重新 “刷屏”。 LLM Planner、VLA、Diffusion Policy、Flow Matching、Latent Action、World Mode
图片不只被编码,还直接参与 Attention、MoE 与 Agent 推理。
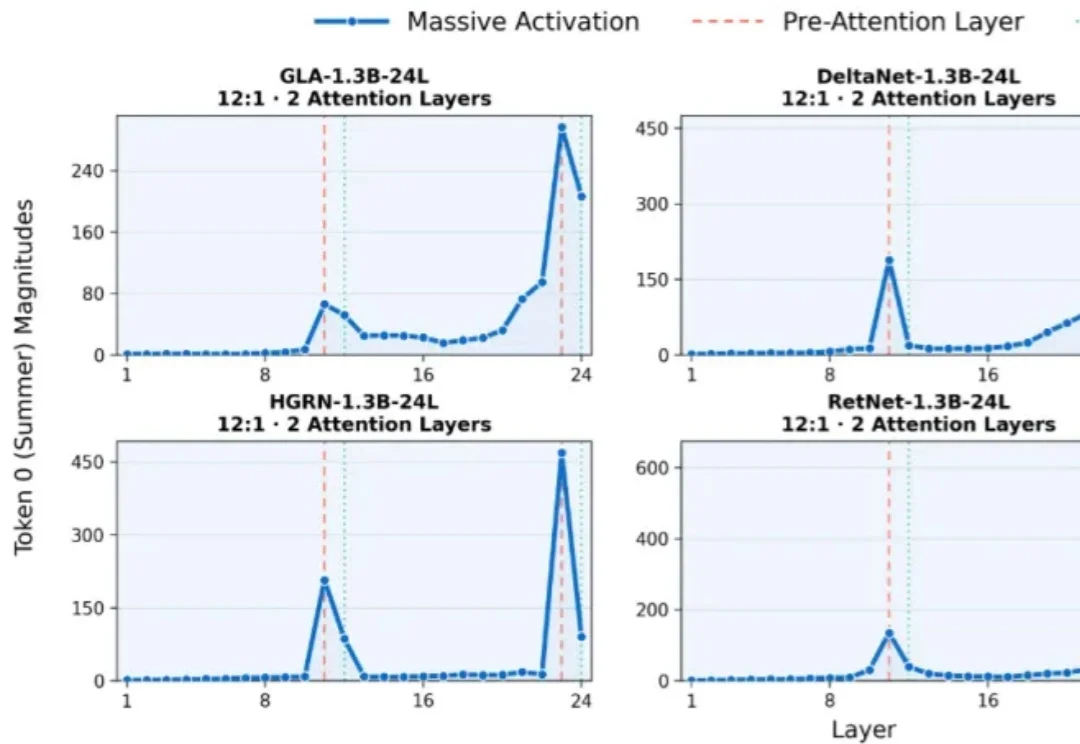
Full Attention 层尚未开始计算,它前一层的激活值已提前「冲上峰值」—— 这就像演唱会主角尚未登台,观众席已提前沸腾。来自 StartLux、清华大学等机构的研究者以 Massive Activations 为探针,首次系统刻画了少数 Full Attention 层在混合线性注意力大模型中留下的「跨层痕迹」,并识别出「注意力前尖峰」(PAS)与「尖峰间平台」(ISP)两种核心形态。
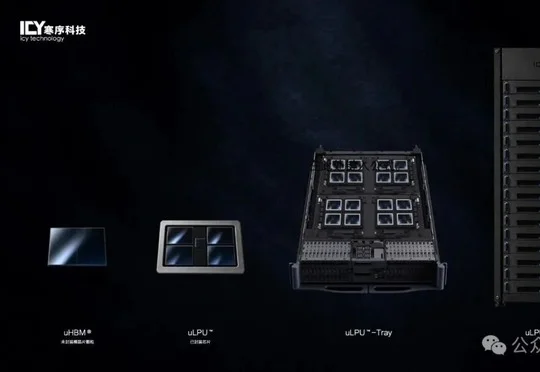
寒序科技正式公布uHBM®与uLPU™推理计算架构,首次完整亮相其基于Persistent MRAM的权重驻留片内计算方案。
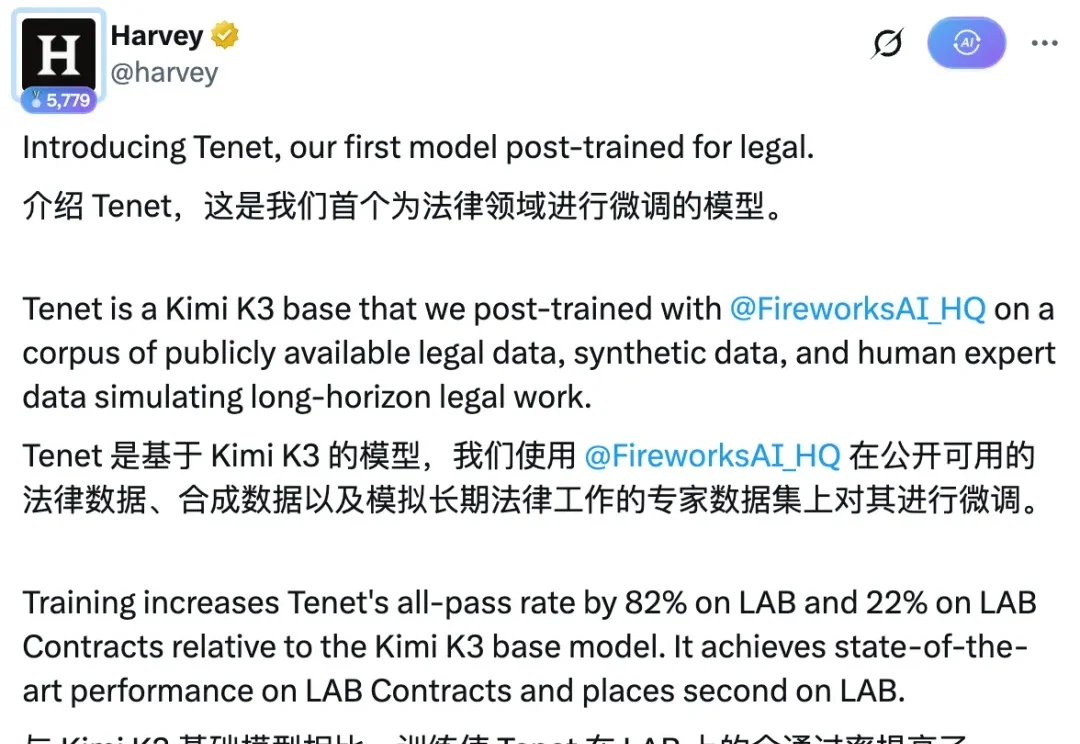
老黄刚砸60亿,要造一个地表最强开源模型。