关于机器人数据,强化学习大佬Sergey Levine刚刚写了篇好文章
关于机器人数据,强化学习大佬Sergey Levine刚刚写了篇好文章我们知道,训练大模型本就极具挑战,而随着模型规模的扩大与应用领域的拓展,难度也在不断增加,所需的数据更是海量。大型语言模型(LLM)主要依赖大量文本数据,视觉语言模型(VLM)则需要同时包含文本与图像的数据,而在机器人领域,视觉 - 语言 - 行动模型(VLA)则要求大量真实世界中机器人执行任务的数据。
搜索
我们知道,训练大模型本就极具挑战,而随着模型规模的扩大与应用领域的拓展,难度也在不断增加,所需的数据更是海量。大型语言模型(LLM)主要依赖大量文本数据,视觉语言模型(VLM)则需要同时包含文本与图像的数据,而在机器人领域,视觉 - 语言 - 行动模型(VLA)则要求大量真实世界中机器人执行任务的数据。
具身智能的突破离不开高质量数据。目前,具身合成数据有两条主要技术路线之争:“视频合成+3D重建”or “端到端3D生成”。英伟达在CES 2025指出“尚无互联网规模的机器人数据”,自动驾驶已具备城市级仿真,但家庭等复杂室内环境缺乏3D合成平台。
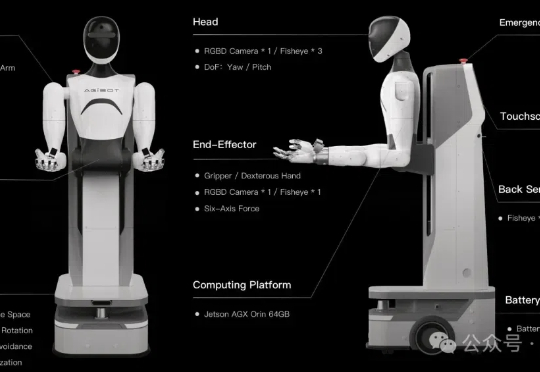
百万真机数据集开源项目AgiBot World,也是全球首个基于全域真实场景、全能硬件平台、全程质量把控的大规模机器人数据集。 该项目由稚晖君具身智能创业项目智元机器人,携手上海AI Lab、国家地方共建人形机器人创新中心以及上海库帕思联合发布。
o3之后,OpenAI下一个项目曝光了: 人形机器人
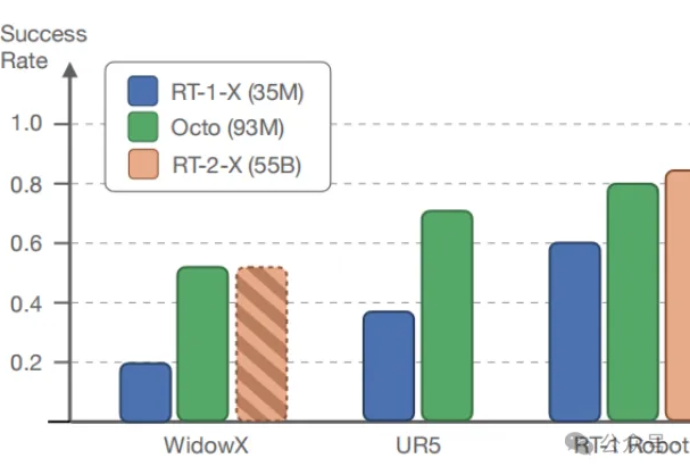
在多样化的机器人数据集上预训练的大型策略有潜力改变机器人学习:与从头开始训练新策略相比,这种通用型机器人策略可以通过少量的领域内数据进行微调,同时具备广泛的泛化能力。
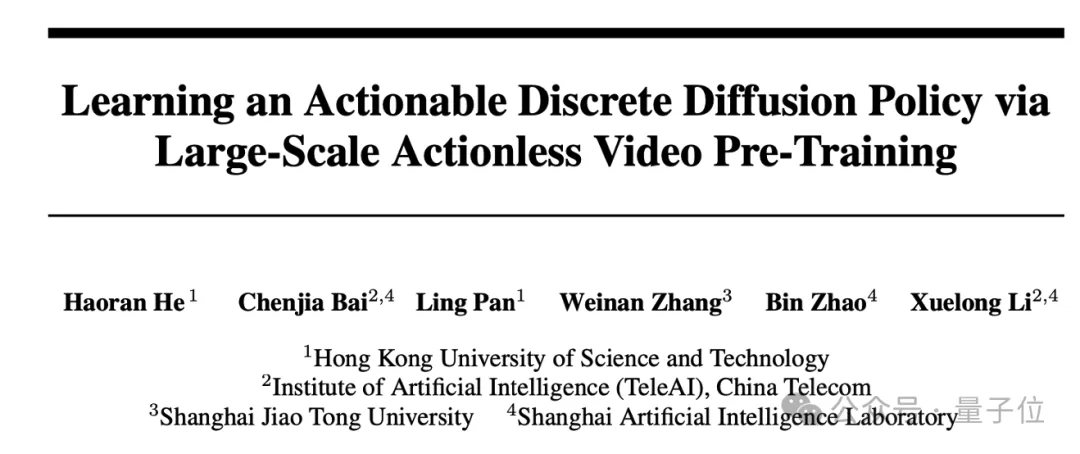
TeleAI 李学龙团队提出具身世界模型,挖掘大量人类操作视频和少量机器人数据的共同决策模式。
具身化AI的未来突破“GPT-3时刻”;三类数据策略,互联网、模拟和真实机器人数据的结合;虚拟世界与现实世界的连接,基础Agent的愿景
今年 3 月,以构建大型开源社区而闻名的 AI 初创公司 Hugging Face,挖角前特斯拉科学家 Remi Cadene 来领导一个新的开源机器人项目 ——LeRobot,引起了轰动。